직업 속 추론 · 유한한 묶음의 표본검사

오탈자5장이 섞인 인쇄물, 20장 검사로 모두 놓칠 수 있을까?

100장 중 정해진 수의 오탈자가 있다는 가상 조건에서, 서로 다른 장을 검사할 때와 같은 장을 반복할 때의 누락 확률을 비교합니다.

차근차근게시 2026-10-20읽기·실험 약 12분확인 문제 2개규칙 기반 실행한국논리학협회 자체 제작제작·검수 LTCT 편집부

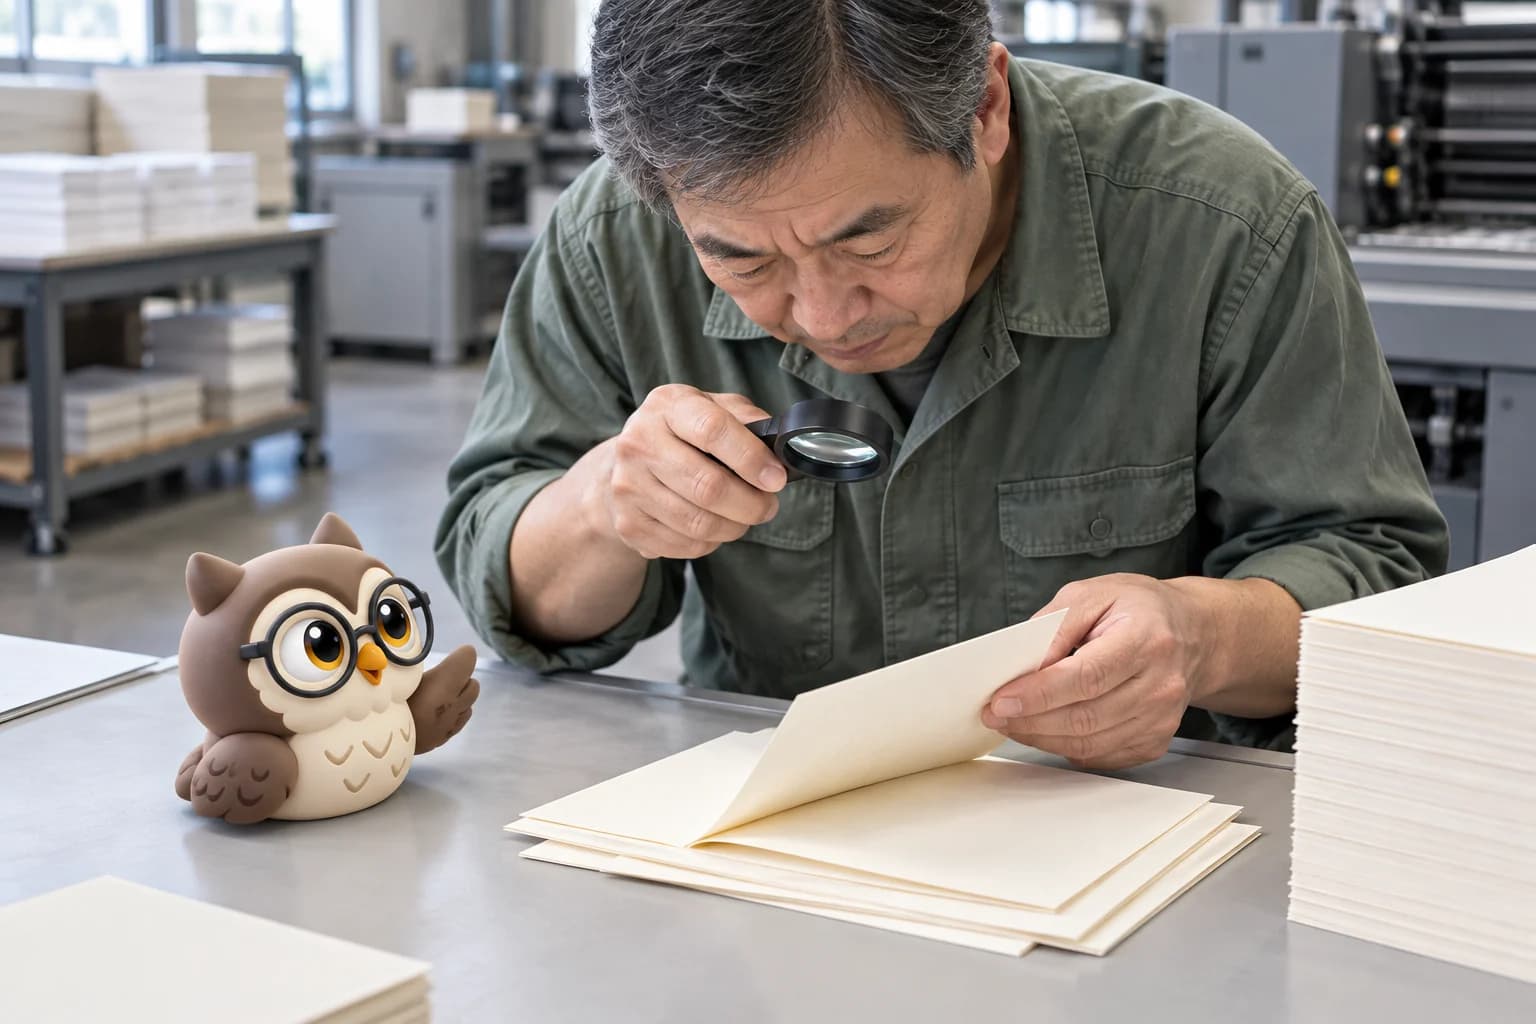
인쇄 작업실에서 종이를 분리해 확대경으로 살피는 남성 기술자와 검사 손짓을 바라보는 작은 공식 올리
AI로 재구성한 교육 장면입니다. 실제 역사 기록이나 현장 검사 사진이 아닙니다. · 주제 이해를 돕기 위한 AI 생성 이미지 · LTCT 자체 제작
오늘의 질문

100장 중 오탈자5장이 있다는 것을 아는 가상 묶음에서, 서로 다른20장을 무작위로 검사했는데 그5장을 하나도 고르지 않을 확률은 얼마일까요?

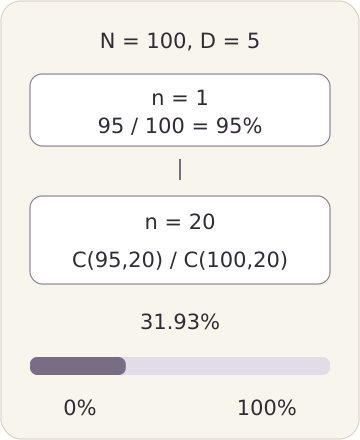
100장 중 오탈자5장인 가상 묶음에서 한 장을 반복 검사하면 누락 확률95%, 서로 다른20장을 무작위로 검사하면 약31.93%입니다. 각 검사는 오탈자를 확실히 판별한다고 가정합니다.
100장 중 오탈자5장인 가상 묶음에서 한 장을 반복 검사하면 누락 확률95%, 서로 다른20장을 무작위로 검사하면 약31.93%입니다. 각 검사는 오탈자를 확실히 판별한다고 가정합니다. · 한국논리학협회 자체 제작
그림 크게 보기 ↗
01

검사를 몇 번 했는지와 몇 장을 봤는지를 나눕니다

인쇄물100장에 오탈자가 있는 장이5장 섞였다고 가정합시다. 눈으로 보면 오탈자를 반드시 찾아내는 검사이며, 어느 장이든 같은 가능성으로 뽑습니다. 여기서 묻는 것은 오탈자5장이 실제로 있다는 조건 아래 표본에 그 장들이 하나도 들어오지 않을 확률입니다.

한 장을 뽑아 스무 번 보는 경우와 서로 다른20장을 보는 경우는 조사 범위가 다릅니다. 같은 장을 다시 검사해도 새로운 장의 정보가 생기지는 않습니다. 반복 검사가 작은 인쇄 오류를 더 잘 발견하게 하는 실제 상황도 있지만, 이 모형은 검사가 처음부터 정확하다고 고정했으므로 그 효과까지 계산하지 않습니다.

02

한 장을 뽑을 때는 정상95장 가운데 골라야 놓칩니다

처음 고른 한 장에 오탈자가 없을 가능성은95/100, 즉95%입니다. 그 장만 스무 번 반복해서 보면 이 가정에서는 누락 확률도95%로 같습니다. 같은 대상을 반복한 횟수를 서로 다른 표본의 수로 세면 검사 범위를 과장하게 됩니다.

서로 다른 두 장을 뽑아 모두 정상일 확률은95/100×94/99입니다. 첫 정상 장을 꺼낸 뒤에는99장 중 정상94장이 남기 때문입니다. 두 번째 조건부 확률의 분모와 분자가 함께 바뀌므로95/100을 계속 곱하는 계산과 구분해야 합니다.

03

스무 장을 모두 놓치는 경우는 유한한 조합으로 셉니다

서로 다른20장을 고르는 모든 경우는100장 중20장을 고르는 조합입니다. 그중 오탈자를 하나도 고르지 않는 경우는 정상95장 안에서20장을 고르는 조합입니다. 두 조합 수의 비가 약0.3193이므로 모두 놓칠 확률은 약31.93%입니다.

검사 장 수를100으로 높이면 모든 장을 보므로 오탈자가 한 장 이상 있는 조건에서 모두 놓칠 확률은0입니다. 반대로 숨은 오탈자 수를0으로 바꾸면 어떤 표본에도 오탈자가 들어오지 않을 확률은1입니다. 활동의0%와100%가 무엇을 조건으로 삼은 값인지 함께 읽어야 합니다.

04

모형의 조건부 확률을 실제 묶음의 진단으로 뒤집지 않습니다

약31.93%는 ‘오탈자5장이 있는데 서로 다른20장에서 하나도 발견하지 못할 확률’입니다. 검사한20장이 정상이었다는 사실만으로 ‘남은 묶음에 오탈자가 있을 확률이31.93%’라고 뒤집을 수는 없습니다. 실제 오탈자 수에 관한 사전 정보와 검사 모형이 더 필요합니다.

NIST의 설명은 표본을 무작위로 뽑고 정해 둔 판정 규칙으로 묶음을 수락하거나 거부하는 절차를 다룹니다. 목적과 필요한 위험 수준을 정하는 일은 표본에서 전체 품질을 임의로 확정하는 일과 구분됩니다. 이 페이지는 공식 품질 규격이나 출고 승인 기준을 제시하지 않습니다.

참고 · 미국 국립표준기술연구소 NIST — 표본으로 한 생산 묶음을 판단할 때 ↗

05

검토 기록에는 표본을 고른 방법도 남깁니다

인쇄물의 앞쪽20장만 보았다면 모든20장 조합이 같은 가능성으로 뽑혔다고 보장할 수 없습니다. 인쇄 오류가 연속해서 생기는 공정이라면 묶음의 순서도 중요한 정보입니다. 활동의 무작위 표본 결과를 편의상 고른 표본에 그대로 적용하지 않습니다.

검사 보고서에는 전체 장 수, 서로 다른 검사 장 수, 표본 선택 방법, 발견한 오탈자, 검사 정확도의 가정을 따로 적어 보세요. ‘스무 번 검사 완료’라는 한 줄보다 실제로 무엇을 확인했고 무엇이 남았는지 구체적으로 설명할 수 있습니다.

직접 확인하기 · 규칙 기반 실행

검사할 서로 다른 장 수와 숨은 오탈자 수 바꾸기

전체100장, 오탈자 수는 교육용으로 미리 아는 가정입니다. 실제 검사 결과에서 오탈자 수를 추정하거나 출고를 승인하는 도구가 아닙니다. 검사 자체는 정확하고 표본은 무작위라고 가정합니다.

어떤 장을 몇 장 검사하나요?

전체100장 · 오탈자5장이라고 가정 · 서로 다른 검사 대상 20장

오탈자를 하나도 고르지 않을 확률: 31.93%

한 장 이상 고를 확률: 68.07%

이것은 오탈자 수를 미리 정했을 때의 표본 결과 확률입니다. 실제 검사 뒤에 오탈자가 남았을 확률이나 출고 승인 판단으로 바꾸어 읽지 않습니다. 같은 장의 재검사도 정확하다는 가정입니다.

관계를 읽고, 다른 상황에 적용하기

두 문제로 생각 확인

1오탈자5장이 있는100장에서 정상 한 장을 뽑아 같은 장만20번 정확히 재검사합니다. 처음부터 오탈자 장을 고르지 않을 확률은?
2오탈자5장이라는 가정에서20장 검사에 아무 오탈자도 들어오지 않을 확률이 약31.93%입니다. 바른 해석은?

두 문제의 답을 모두 선택하면 해설을 볼 수 있습니다.

나의 설명으로 마무리

오늘 발견한 관계

0 / 4,000자

메모는 현재 기기의 브라우저에만 보관됩니다. 계정이나 다른 기기에는 동기화되지 않습니다.

출처와 제작 안내

원문을 참고해 설명·도표·문항·실험을 새로 작성했습니다. 별도 표시가 없는 사례와 수치는 학습을 위한 가상 예시입니다. 원문 번역이나 실제 모델의 성능 평가 자료가 아닙니다.

  1. 표본으로 한 생산 묶음을 판단할 때 ↗미국 국립표준기술연구소 NISTNIST/SEMATECH e-Handbook 6.2.1 What is Acceptance Sampling?; Dataplot Single Sample Acceptance Plan

    무작위 표본을 통한 묶음의 수락·거부와 품질추정의 구분을 읽었습니다. NIST Dataplot의 single-sample 설명에서 초기하분포 사용도 확인했습니다. 인쇄물100장·오탈자 수·아래 유한 조합 계산은 자체 가상 자료와 자체 검산입니다. 확인일2026-10-20.