‘사람과 책’만 듣고 알 수 있는 것
AI가 사진 속 사람과 책을 정확히 찾아냈습니다. 독서 모임을 소개하는 글에 ‘사람과 책’이라는 설명을 붙이면 독자는 정작 어떤 활동이 벌어지는지 알기 어렵습니다. 사진을 볼 수 없는 독자에게 필요한 정보는 물체 이름보다 이 글에서 사진이 맡은 역할에 가깝습니다.
이미지가 전하는 뜻을 글로 제공하는 것이 대체 텍스트입니다. 이 사진이 토론 방법을 보여 주는 핵심 자료라면 ‘참가자가 책을 펼치고 자기 주장의 근거가 될 문장에 표시한다’는 말이 독서 모임의 특징을 전합니다.
본문 삽화가 버튼이 되는 순간
같은 그림이 글 가장자리를 꾸미기만 하고 읽어야 할 정보가 본문에 다 들어 있다면 빈 대체 텍스트(alt="")를 쓸 수 있습니다. 빈 값을 명시하면 보조기술이 순수한 장식 이미지를 건너뛸 수 있습니다.
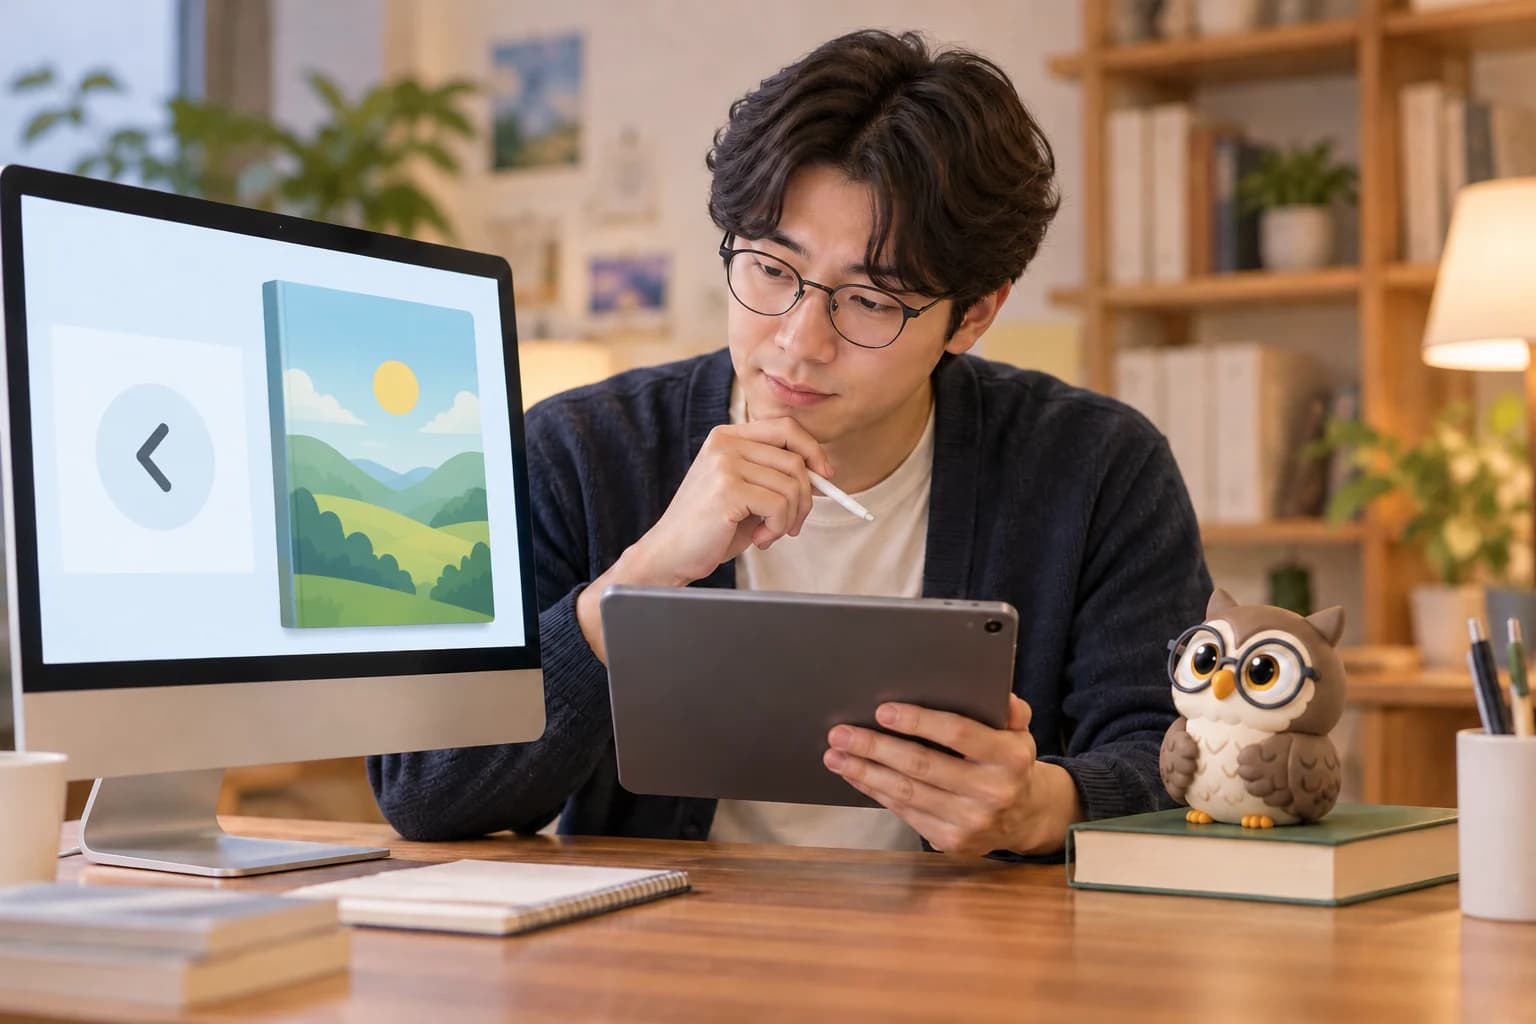
그 그림이 이전 글로 이동하는 버튼 안의 유일한 표시라면 어떤 말이 필요할까요? ‘책 그림’보다 ‘이전 회차 열기’가 누른 뒤 일어날 일을 알려 줍니다. 옆에 이미 같은 이름의 글자가 있고 버튼의 이름으로 읽힌다면 그림 설명까지 거듭 들려줄 필요는 없습니다.
막대 두 개의 높이를 말로 옮기면
독서 모임에 첫해 20명, 다음 해 30명이 참여한 가상의 그래프를 생각해 봅시다. ‘막대그래프’라는 말로는 어느 해의 참여가 얼마나 늘었는지 알 수 없습니다. 짧은 설명에 주제를 밝히고 근처에 수치 표나 자세한 설명을 두면 독자가 직접 비교할 수 있습니다.
실습에서 ‘복잡한 그래프’를 고르면 표의 두 값은 20과 30입니다. 차이는 10명이고 첫해를 기준으로 한 증가율은 10÷20=50%입니다. 숫자와 비교 기준을 함께 전하면 그림이 있든 없든 같은 판단을 내릴 수 있습니다.
AI에게 사진과 함께 건넬 단서
사진 한 장만 받은 AI는 그 그림이 링크인지, 옆 문장에 같은 설명이 있는지 확인하기 어렵습니다. 페이지 제목, 주변 문장, 버튼이 향하는 곳을 함께 알려 주면 무엇을 독자에게 들려줄지 판단할 근거가 생깁니다.
역할을 ‘장식’, 문맥을 ‘버튼’으로 골라 보세요. 실습은 두 선택이 어울리는지 다시 묻습니다. 이때 확인할 것은 그림의 생김새보다 버튼에 이미 읽을 수 있는 이름이 있는지, 그 이름만 듣고도 어디로 가는지 알 수 있는지입니다.