한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과53건

검색 결과 제목

  1. 31시험 답을 바꿨다가 틀린 기억이 왜 더 오래 남을까?
  2. 32보기 순서만 바꿔도 AI의 선택이 달라질까?
  3. 33AI 심판은 자기 계열의 답을 더 좋아할까?
  4. 34답이 길면 AI 심판은 더 좋은 답으로 볼까?
  5. 35각자 순서가 분명한데 공동 1등은 없을 수 있을까?
처음 답과 최종 답의 정오를 네 칸으로 나누고 실제 빈도와 기억의 두드러짐을 구분한 표

시험 답을 바꿨다가 틀린 기억이 왜 더 오래 남을까?

처음 답과 최종 답의 정오를 네 칸으로 나누고 실제 빈도와 기억의 두드러짐을 구분한 표
논리교육과 평가해외 학술 연구 · 연구 해설 · 일반

시험 답을 바꿨다가 틀린 기억이 왜 더 오래 남을까?

네 연구는 정답을 오답으로 바꾼 경우가 오답을 정답으로 고친 경우보다 더 후회되고 잘 기억돼, 첫 답을 지켜야 한다는 믿음을 강화할 수 있음을 보였습니다.

Counterfactual Thinking and the First Instinct Fallacy
게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면

AI 심판은 자기 계열의 답을 더 좋아할까?

현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

AI 심판은 자기 계열의 답을 더 좋아할까?

내용 조건은 같은 익명 답 A·B를 심판 A·B와 사람 루브릭이 평가할 때 88:78, 77:87, 80:80으로 달라지는 교육용 감사를 수행합니다.
게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →
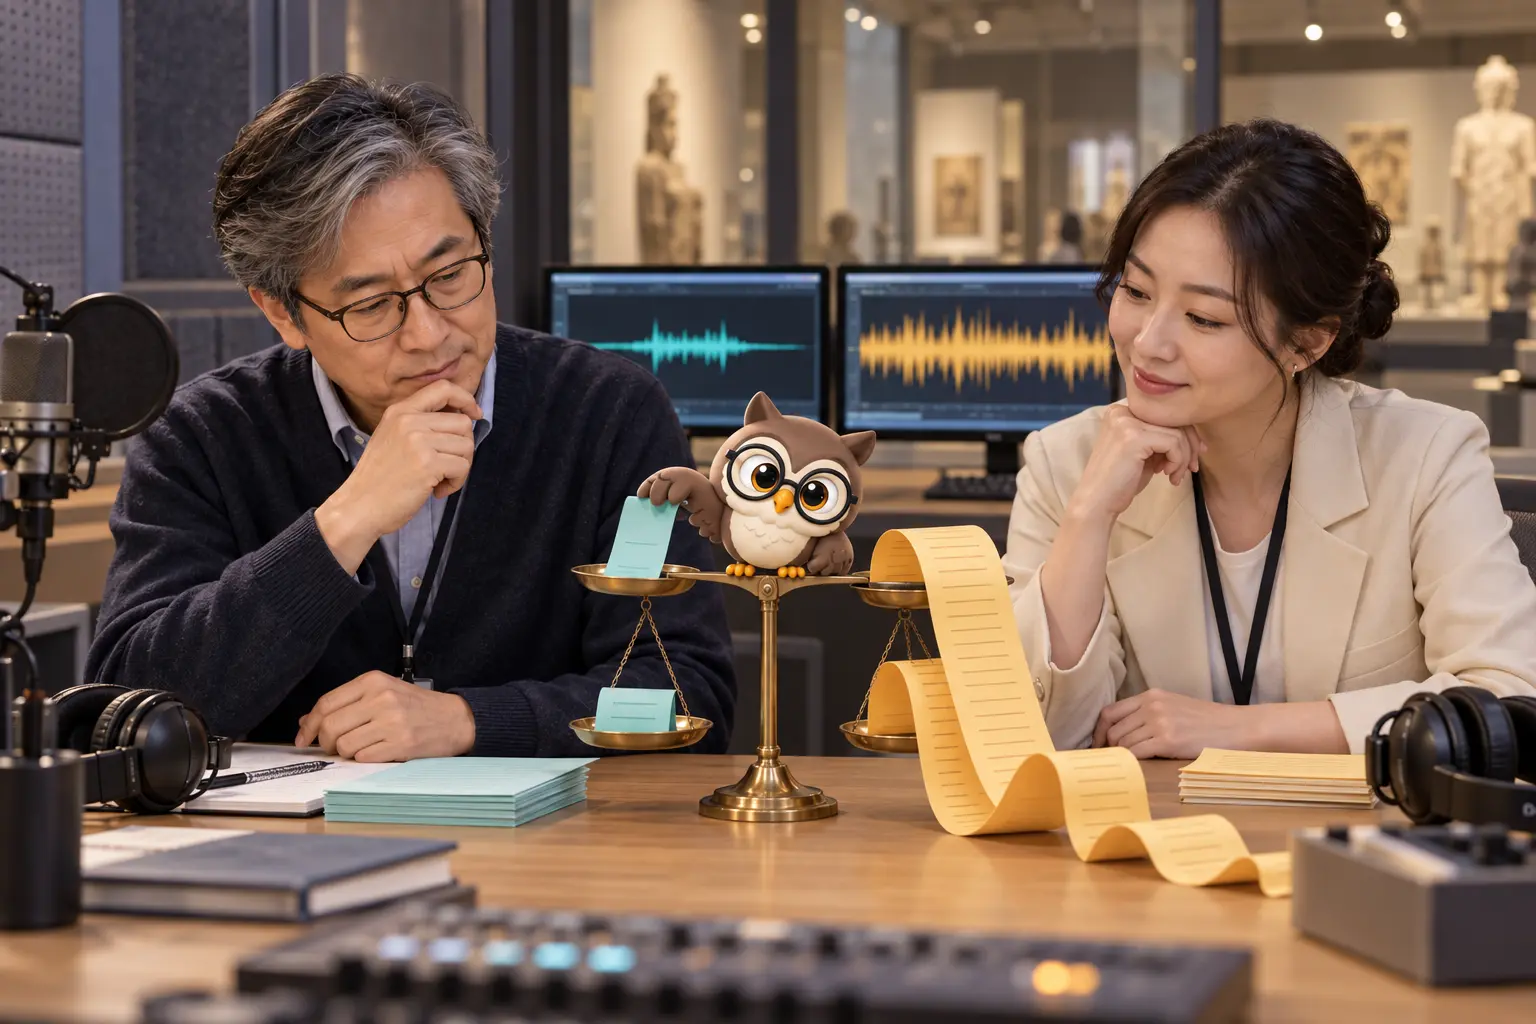
박물관 음성 안내 편집실에서 남성 접근성 편집자와 여성 큐레이터가 짧은 청록 대본과 긴 주황 대본을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 저울 위에서 두 대본을 받치는 장면

답이 길면 AI 심판은 더 좋은 답으로 볼까?

박물관 음성 안내 편집실에서 남성 접근성 편집자와 여성 큐레이터가 짧은 청록 대본과 긴 주황 대본을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 저울 위에서 두 대본을 받치는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

답이 길면 AI 심판은 더 좋은 답으로 볼까?

핵심 근거는 2개로 같은 60단어·180단어 답을 길이 보너스 규칙과 근거 루브릭으로 채점해 선택이 뒤집히는 과정을 확인합니다.
게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →

31–35 / 53편