
길이는 내용과 함께 움직이는 대리 신호다
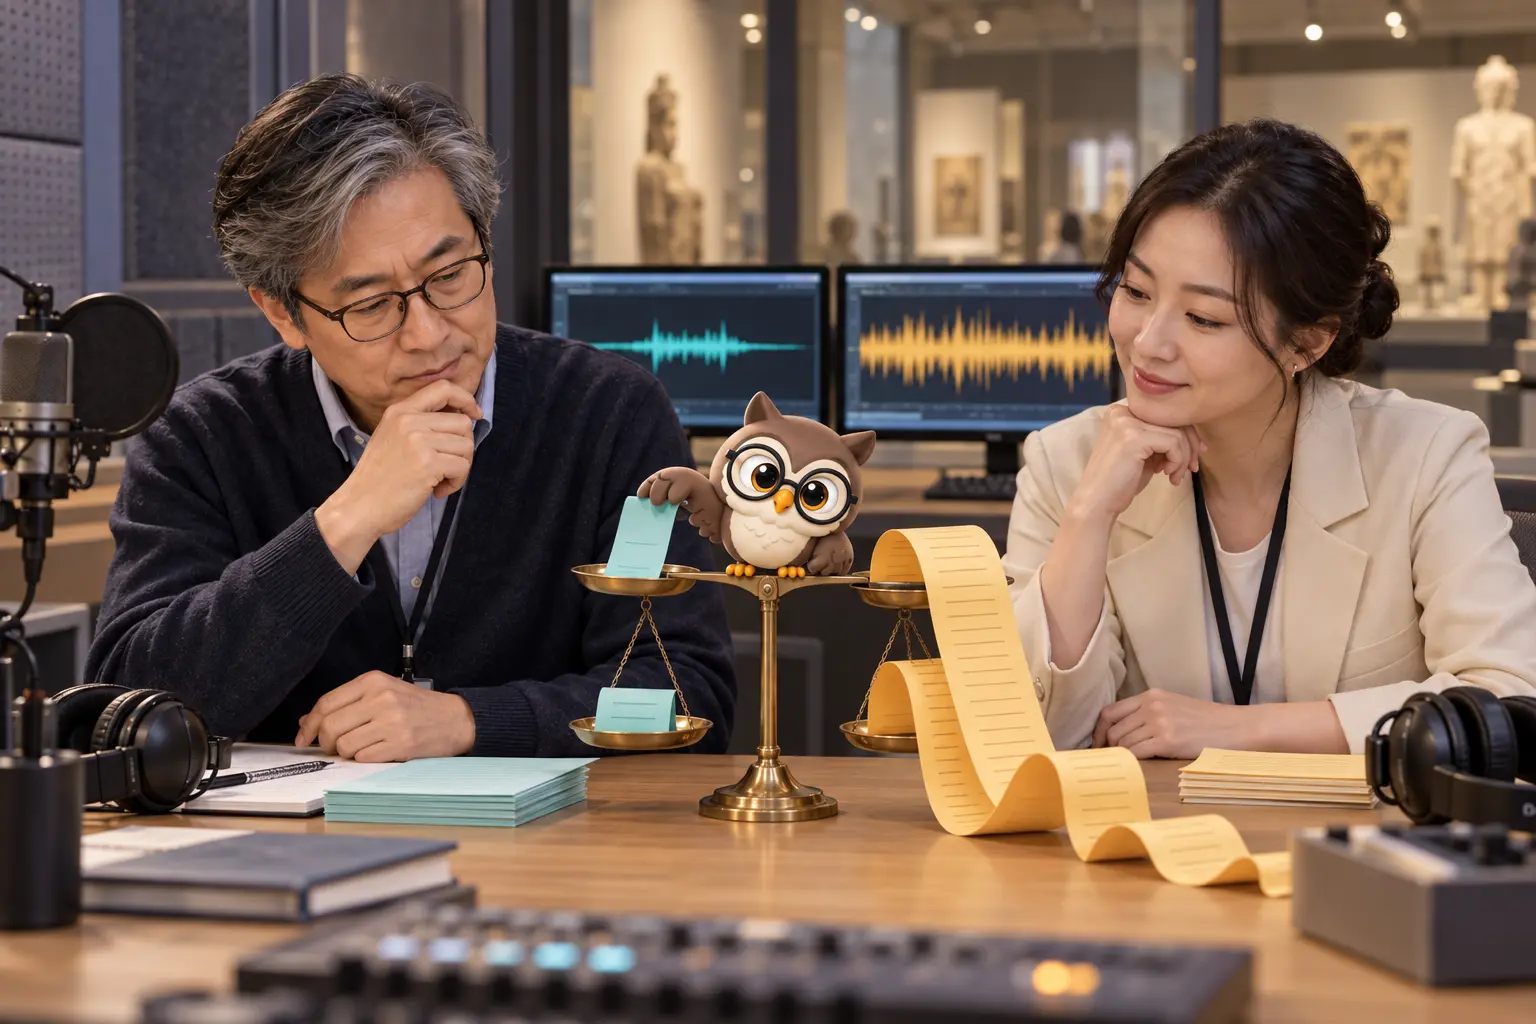
박물관 음성 안내 답변 두 개를 비교한다고 합시다. 짧은 답은 60단어이고 요구한 핵심 근거 2개를 모두 담으며 관련 없는 대목은 없습니다. 긴 답은 180단어이고 같은 핵심 2개를 담지만 곁가지가 3개입니다. 이는 길이 신호를 분리하려고 만든 자료이지 실제 모델 응답이 아닙니다.
‘핵심 1개당 2점, 150단어 이상이면 1점 추가’라는 겉모양 규칙은 짧은 답 4점, 긴 답 5점을 줍니다. 핵심 충족은 같은데 길이 보너스가 승자를 만듭니다. 이 결과는 규칙을 정확히 실행했지만 더 유용한 답을 찾았다는 뜻은 아닙니다.
Saito와 동료들은 그들의 창작형 질문과 인간 선호 자료 설정에서 GPT-4가 인간보다 긴 답을 더 선호하는 경향을 보고했습니다. 연구는 길이 차이에 따른 인간 일치도와 편향 지표를 살폈습니다. 모든 과제와 최신 모델에서 같은 크기의 편향이 난다는 보편 법칙은 아닙니다.
긴 답이 언제나 나쁘다는 결론도 피해야 합니다. 복잡한 안전 절차나 근거 설명에서는 필요한 세부가 늘면서 길이도 늘 수 있습니다. 길이를 아예 무시하거나 일괄 감점하는 대신, 요구된 증거·정확성·관련성이 실제로 더 충족됐는지 확인해야 합니다.
참고 · Keita Saito, Akifumi Wachi, Koki Wataoka, Youhei Akimoto — LLM 선호 표기의 장황성 편향 ↗
평가 기준을 먼저 쪼개야 편향을 볼 수 있다
활동의 ‘근거 루브릭’은 핵심 근거 하나당 2점, 관련 없는 대목 하나당 1점을 뺍니다. 짧은 답은 4점, 긴 답은 1점입니다. 같은 입력이지만 평가 기준을 겉모양에서 주장 지원으로 바꾸자 선택이 뒤집힙니다. 이 역시 교육용 규칙이지 실제 AI 심판의 숨은 사고를 드러내지 않습니다.
Zhou와 동료들은 지시를 어기면서도 장황함·유창함 같은 표면 품질이 좋은 답을 대조 예로 구성해 LLM 심판 편향을 측정했습니다. 공개 논문의 실험은 보정 프롬프트와 학습 방법이 표면 신호의 영향을 줄일 수 있음을 보였지만, 특정 벤치마크와 모델에서의 결과입니다.
실무 루브릭은 ‘정답인가’ 한 줄보다 세분되어야 합니다. 핵심 주장별 근거, 사실 오류, 요청 형식, 불필요한 반복을 따로 표시하고 각 항목의 우선순위를 사전에 정합니다. 길이 자체는 진단 변수로 기록하되, 점수는 요구 조건을 충족한 정보에 연결합니다.
비교 순서도 바꿔 보고, 답변에서 모델 이름과 말투 같은 표면 단서를 가린 뒤 다시 평가합니다. 길이만 다르고 의미 품질은 맞춘 쌍, 짧지만 누락된 답, 길지만 필요한 세부가 있는 답을 모두 넣어야 ‘짧은 답 선호’라는 반대 편향도 발견할 수 있습니다.
심판 점수도 사람 기준으로 감사한다
운영에서는 AI 심판의 점수를 바로 정답표로 쓰지 않습니다. 사람이 독립적으로 표시한 핵심 근거 충족과 비교하고, 사람이 짧은 답을 골랐을 때와 긴 답을 골랐을 때의 일치율을 나눠 봅니다. 전체 일치율 하나만 보면 어느 길이 집단에서 실패하는지 가려집니다.
길이 구간, 과제 유형, 언어와 난이도별로 오류를 기록합니다. 위치를 바꾼 재평가와 여러 심판의 합의는 변동을 드러낼 수 있지만 같은 훈련 자료와 대리 신호를 공유하면 오류도 함께 반복할 수 있습니다. 고위험 채택·탈락 결정에는 사람 검토와 이의 제기 경로를 둡니다.
이 글의 60·180단어, 핵심 2개와 무관 3개, 4·5·1점은 원리를 눈에 보이게 한 자체 숫자입니다. Saito 연구의 실제 표본이나 Zhou 연구의 점수를 옮긴 것이 아닙니다. 연구 결과는 평가 편향의 가능성과 검사 방법을 뒷받침하며 이 작은 규칙의 성능을 보증하지 않습니다.
다른 상황으로 옮겨 보세요. 자기소개서, 상담 답변, 코드 설명을 AI가 평가할 때 길이가 어떤 품질의 대리 신호가 될까요? 반드시 들어가야 할 근거, 허용할 세부, 감점할 반복, 길이를 맞춘 대조쌍과 사람이 감사할 표본을 먼저 설계해 보세요.
참고 · Keita Saito, Akifumi Wachi, Koki Wataoka, Youhei Akimoto — LLM 선호 표기의 장황성 편향 ↗