한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과47건

검색 결과 제목

  1. 26인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?
  2. 27AI가 모를 때 멈추면 더 믿을 수 있을까?
  3. 28AI가 ‘완료했습니다’라고 쓰면 실제 작업도 끝난 걸까?
  4. 29입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?
  5. 30상관이 높으면 두 측정법을 바꿔 써도 될까?
원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

AlphaProof는 Lean 검증 환경, 대규모 자기학습과 문제별 시험시점 강화학습을 결합해 2024 IMO 비기하 5문제 중 3문제를 풀었지만 막대한 계산비용과 형식화 범위가 제한입니다.

Olympiad-level Formal Mathematical Reasoning with Reinforcement Learning

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
대학 지도 보관소에서 젊은 남성과 은발 여성이 스캔 조각을 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 보류 표식을 들고 지도 카드를 사람 검토 상자로 옮기는 장면

AI가 모를 때 멈추면 더 믿을 수 있을까?

대학 지도 보관소에서 젊은 남성과 은발 여성이 스캔 조각을 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 보류 표식을 들고 지도 카드를 사람 검토 상자로 옮기는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

AI가 모를 때 멈추면 더 믿을 수 있을까?

신뢰도 문턱을 높일수록 응답 범위와 응답한 사례의 오류가 어떻게 함께 달라지는지 계산하고, 보류를 포함한 운영 기준을 세웁니다.

게시 2026-09-13 · 약 14분논리학 학습 글 읽기 →
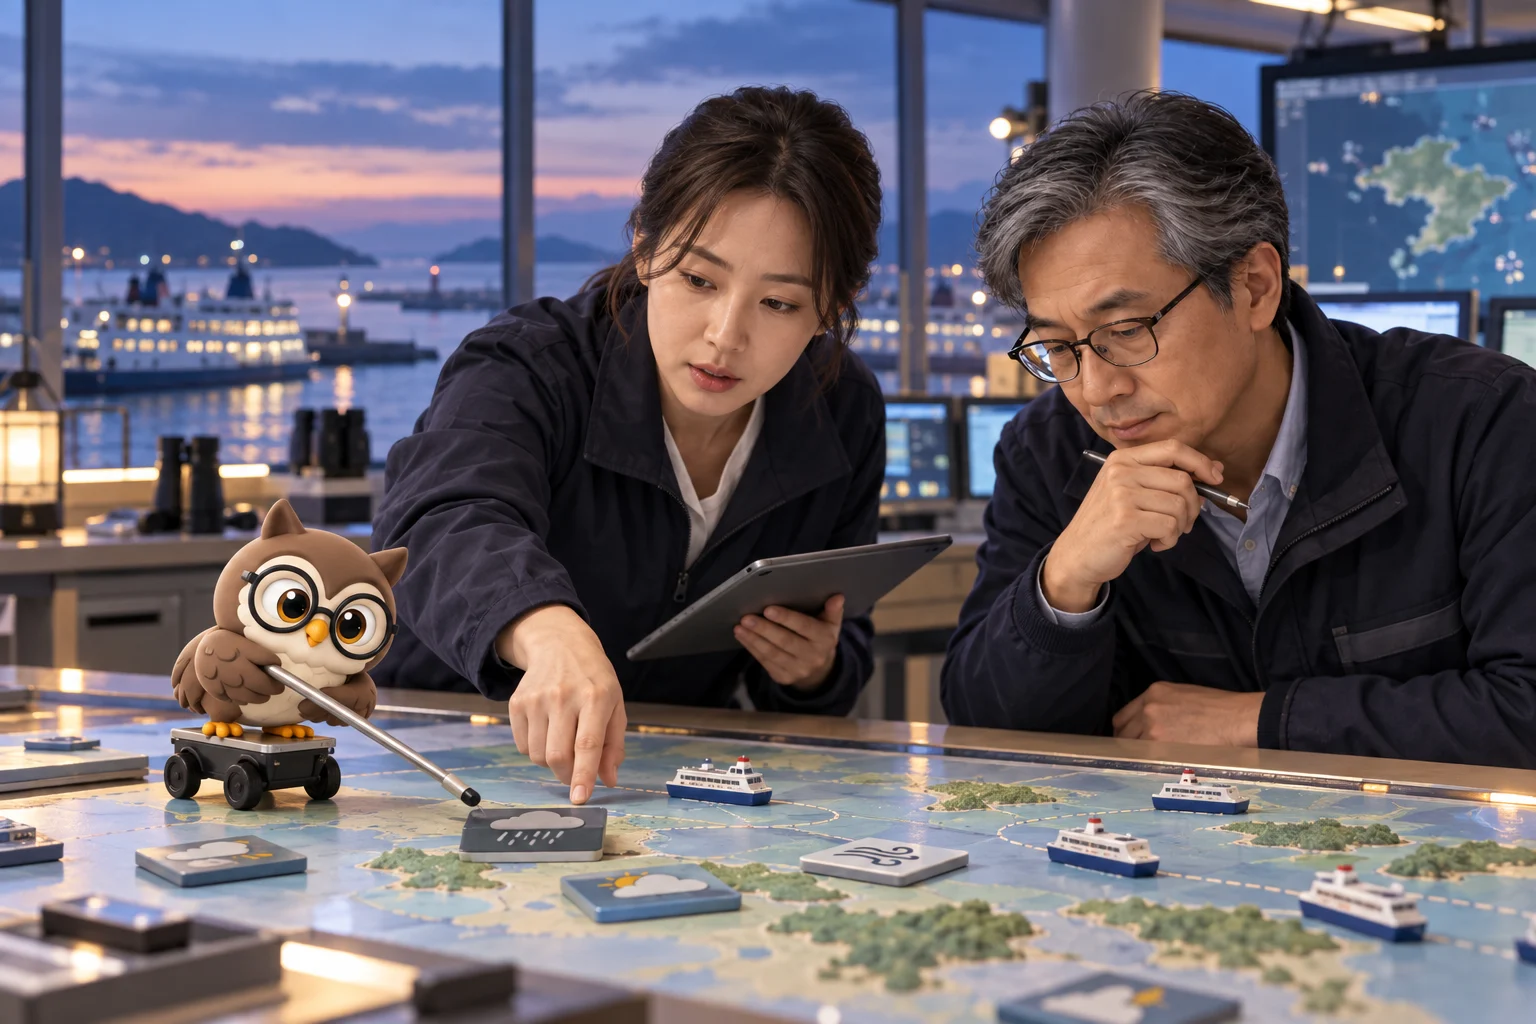
해질녘 연안 여객선 운영실에서 여성 운영자와 남성 운영자가 지도와 문서 표식을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 지시봉을 들고 참여하는 장면

입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?

해질녘 연안 여객선 운영실에서 여성 운영자와 남성 운영자가 지도와 문서 표식을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 지시봉을 들고 참여하는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?

전체 정확도 82%가 66%로 같게 떨어져도 입력 구성 80·20→40·60의 변화와 조건별 정확도 90%→70%의 관계 변화는 다른 진단임을 비교합니다.

게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →

26–30 / 47편