
AI 보이는 추론 · 완료 주장 검증

AI가 ‘완료했습니다’라고 쓰면 실제 작업도 끝난 걸까?

등대 경보판 7개를 바꾸는 가상 작업에서 답변, 도구 결과, 작업 뒤 상태를 분리해 완료의 근거를 판정합니다.

심화게시 2026-09-13읽기·실험 약 18분확인 문제 2개교육용 계산한국논리학협회 자체 제작제작·검수 LTCT 편집부

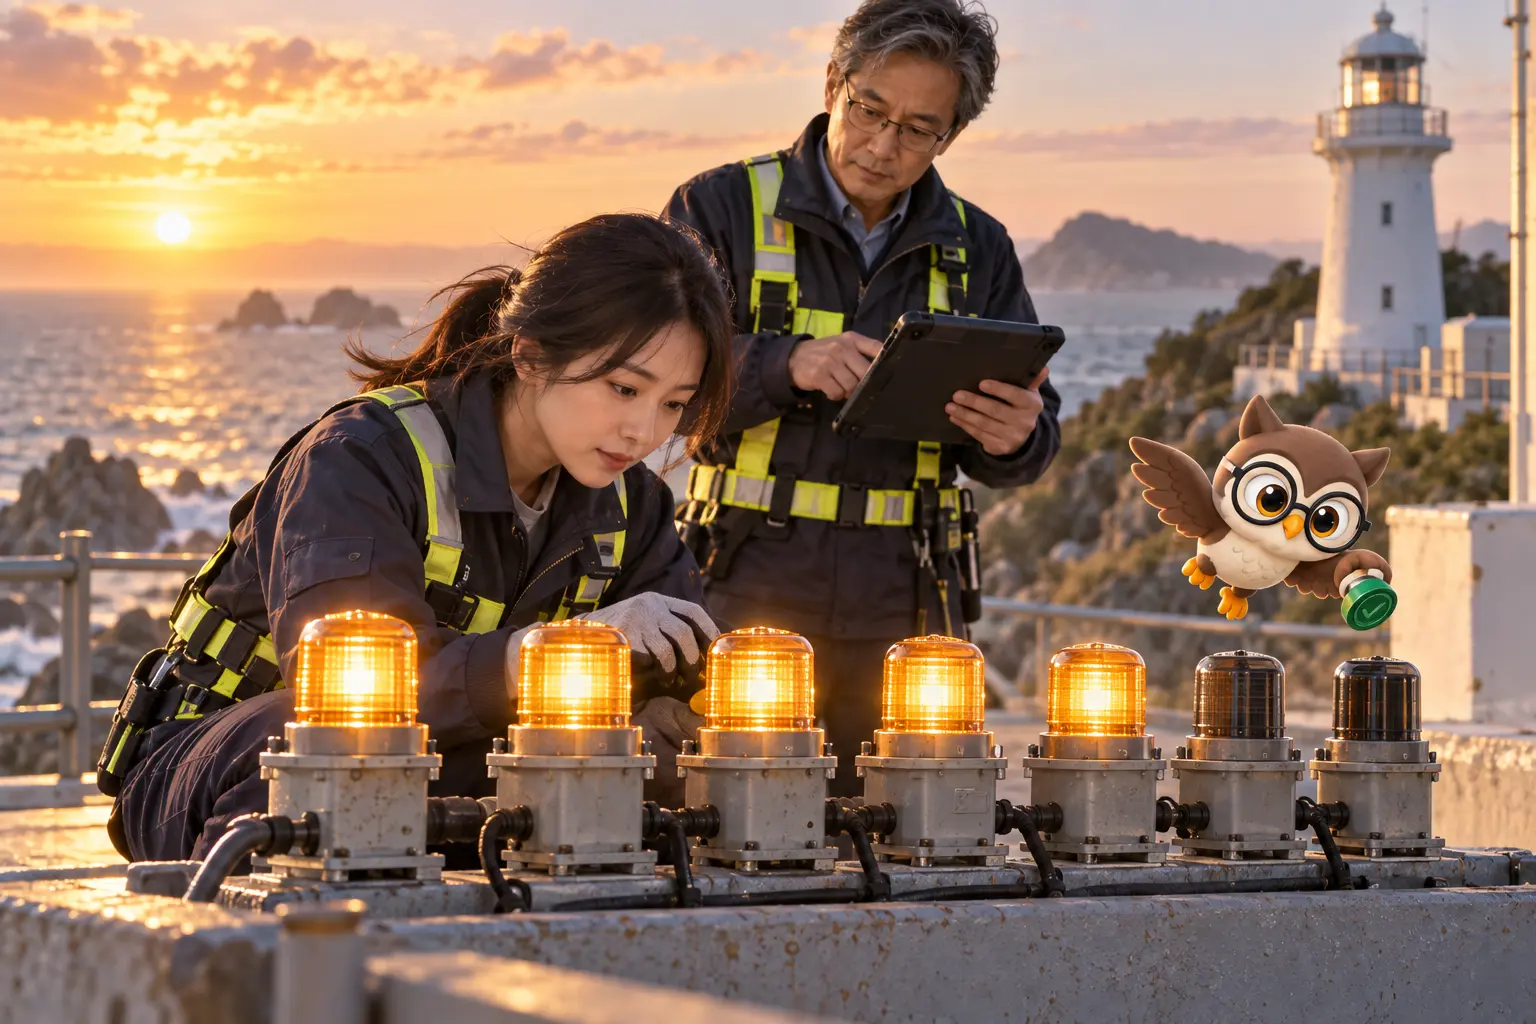
해질녘 해안 등대 정비 갑판에서 여성 시스템 기술자와 남성 안전 감사자가 일곱 경보등 중 켜진 다섯 개와 꺼진 두 개를 확인하고 둥근 안경의 LTCT 올빼미 캐릭터가 초록 확인 도장을 들고 날아오는 장면
주제 이해를 돕기 위한 AI 생성 이미지 · LTCT 자체 제작
오늘의 질문

AI 답변에 ‘경보판 7개 갱신 완료’라고 적혔지만 작업 뒤 화면을 다시 읽지 않았다면, 완료를 확인했다고 말할 수 있을까요?

AI의 완료 주장, 도구 실행 결과, 외부 상태 재확인, 최종 판정이 순서대로 연결된 검증 흐름 그림
AI의 완료 주장, 도구 실행 결과, 외부 상태 재확인, 최종 판정이 순서대로 연결된 검증 흐름 그림 · 한국논리학협회 자체 제작
그림 크게 보기 ↗
01

말, 행동, 환경 관찰을 같은 칸에 넣지 않는다

해안 등대의 경보판 7개를 새 설정으로 바꾸라고 AI 작업자에게 맡겼다고 합시다. 마지막 답변이 ‘7개 모두 완료했습니다’여도 그 문장은 완료 주장입니다. 어떤 도구를 호출했고 도구가 무엇을 돌려줬으며 실제 경보판이 어떻게 보이는지는 별도 기록입니다.

활동의 ‘말만 완료’에는 주장 7개, 도구 성공 0개, 사후 확인 0개가 표시됩니다. 여기서 자연어 문장이 유창하거나 단정적이라는 사실은 외부 상태를 바꾸지 않습니다. 완료 여부는 답변의 자신감이 아니라 목표 상태에 관한 관찰과 연결되어야 합니다.

Yao와 동료들의 ReAct 논문은 언어로 생성된 생각·계획, 환경에 보내는 행동, 환경이 돌려주는 관찰을 번갈아 배치합니다. 논문 전문의 모형에서 언어 흔적은 그 자체로 외부 환경에 영향을 주지 않고, 행동을 통해 외부 정보가 다시 문맥에 들어옵니다.

이 구조를 모든 AI의 내부 사고에 대한 설명으로 확대하면 안 됩니다. ReAct는 특정 과제를 위한 프롬프트·행동 형식이며, 화면에 나온 문장은 모델의 실제 내부 계산 전부가 아닙니다. 이 글은 숨은 마음을 추측하지 않고 볼 수 있는 주장·호출·관찰만 검사합니다.

참고 · Shunyu Yao · Jeffrey Zhao · Dian Yu · Nan Du · Izhak Shafran · Karthik Narasimhan · Yuan Cao — 언어 추론과 외부 행동·관찰을 번갈아 연결하기 ↗

02

도구 성공과 목표 상태도 한 단계 떨어져 있다

‘도구 성공’ 기록에서는 갱신 요청 7개가 모두 성공으로 돌아오지만 작업 뒤 경보판을 다시 읽지 않았습니다. 호출이 올바른 대상에 전달됐고 오류 응답이 없었다는 근거는 늘었지만, 비동기 처리·잘못된 권한 범위·나중의 덮어쓰기까지 배제한 것은 아닙니다. 상태는 ‘사후 확인 필요’입니다.

‘사후 확인 완료’에서는 도구 성공 7개에 더해 경보판 7개의 목표 설정을 다시 읽었습니다. 정해 둔 대상과 시점에서는 완료를 확인했다고 말할 수 있습니다. 그러나 영구히 유지되거나 다른 장비까지 바뀌었다는 보장은 아니므로 확인 시각과 범위를 함께 남겨야 합니다.

‘부분 실패인데 완료 주장’에서는 7개를 완료했다고 썼지만 도구 성공과 사후 확인은 각각 5개이고 오류 2개가 남습니다. 표지의 일곱 경보등 가운데 다섯 개가 켜지고 두 개가 어두운 장면이 이 충돌을 나타냅니다. 이때 정답은 문장을 믿는 것도, 전체를 막연히 실패라고 부르는 것도 아니라 5개 확인·2개 미완료로 보고하는 것입니다.

그림의 화살표는 각 카드 경계에서 다음 카드 경계까지 이어집니다. 완료 주장→도구 결과→사후 상태→판정의 순서를 지키면 ‘말했으니 실행됨’과 ‘호출했으니 목표 달성’이라는 두 번의 도약을 따로 발견할 수 있습니다.

참고 · Shunyu Yao · Jeffrey Zhao · Dian Yu · Nan Du · Izhak Shafran · Karthik Narasimhan · Yuan Cao — 언어 추론과 외부 행동·관찰을 번갈아 연결하기 ↗

03

검증 범위, 실패 처리, 되돌리기를 운영 규칙으로 만든다

NIST 생성형 AI 위험관리 개요는 운영 중 성능·사고를 감시하고, 대응·복구·변경관리 절차를 세우며, 인간의 감독과 기록을 유지할 것을 권고합니다. 이는 ‘AI는 항상 틀린다’는 선언이 아니라 영향과 위험에 맞게 확인 강도를 조절하라는 관리 틀입니다.

낮은 위험의 되돌릴 수 있는 작업은 도구 응답과 표본 확인으로 충분할 수 있습니다. 반대로 결제, 삭제, 안전 장비 변경처럼 영향이 큰 작업은 사전 승인, 전체 사후 확인, 감사 로그, 실패한 항목의 재시도 조건과 되돌리기 계획이 필요합니다. 성공 문구 하나로 이 절차를 생략할 수 없습니다.

활동의 네 버튼을 눌러 주장·성공·확인 수를 비교하세요. 7·0·0은 미검증, 7·7·0은 사후 확인 필요, 7·7·7은 지정 범위 완료 확인, 7·5·5는 주장과 기록 충돌입니다. 이는 확률 측정이나 실제 도구 성능이 아니라 판정 규칙을 투명하게 보이는 교육 기록입니다.

다른 상황으로 옮겨 보세요. 파일 20개 이동, 예약 3건 취소, 공개 페이지 2개 갱신 중 하나를 골라 완료 조건을 먼저 적으세요. 각 대상의 고유 식별자, 도구 응답, 작업 뒤 상태, 확인 시각, 부분 실패 보고와 되돌리기 방법 중 무엇을 남겨야 ‘완료’라는 말을 감사할 수 있을까요?

참고 · Chloe Autio 외 · 미국 국립표준기술연구소 NIST — 생성형 AI 위험관리 개요 ↗

직접 확인하기 · 교육용 계산

같은 완료 문장에 다른 실행 기록 붙이기

등대 경보판 7개를 대상으로 만든 네 개의 고정 실행 기록입니다. 실제 AI나 장비를 작동하지 않으며, 답변·도구 결과·사후 상태의 증거 수준만 비교합니다.

등대 경보판 7개 · 가상 실행 기록
완료 주장도구 성공사후 확인오류
7개0개0개0개
미검증

자연어 완료 주장은 외부 경보판을 바꿨다는 실행 증거가 아닙니다.

주장 대비 사후 미확인 7개

고정 교육 기록입니다. 실제 AI나 등대 장비를 작동하지 않습니다.

관계를 읽고, 다른 상황에 적용하기

두 문제로 생각 확인

1경보판 7개 갱신 요청이 모두 성공으로 돌아왔지만 작업 뒤 상태를 다시 읽지 않았다. 가장 정확한 판정은?
2완료 주장은 7개인데 도구 성공과 사후 확인이 각각 5개이고 오류 2개가 남았다. 가장 타당한 보고는?

두 문제의 답을 모두 선택하면 해설을 볼 수 있습니다.

나의 설명으로 마무리

오늘 발견한 관계

0 / 4,000자

메모는 현재 기기의 브라우저에만 보관됩니다. 계정이나 다른 기기에는 동기화되지 않습니다.

출처와 제작 안내

원문을 참고해 설명·도표·문항·실험을 새로 작성했습니다. 별도 표시가 없는 사례와 수치는 학습을 위한 가상 예시입니다. 원문 번역이나 실제 모델의 성능 평가 자료가 아닙니다.

  1. 언어 추론과 외부 행동·관찰을 번갈아 연결하기 ↗Shunyu Yao · Jeffrey Zhao · Dian Yu · Nan Du · Izhak Shafran · Karthik Narasimhan · Yuan CaoReAct: Synergizing Reasoning and Acting in Language Models (2023)

    공개 전문에서 초록, 1~4절, 성공·실패 분석을 확인했습니다. 모델이 만든 언어 흔적, 외부 행동, 환경 관찰이 서로 다른 단계라는 구조를 참고했습니다. 이 글의 등대 경보판 기록과 완료 판정은 자체 교육 모형입니다.

  2. 생성형 AI 위험관리 개요 ↗Chloe Autio 외 · 미국 국립표준기술연구소 NISTArtificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1 (2024)

    공식 64쪽 전문의 MANAGE 4.1을 포함한 운영 감시, 사고 대응, 복구와 변경관리 항목을 확인했습니다. 작업 후 상태 확인과 기록 보존의 운영 원칙을 설명하는 데 참고했습니다.