답이 길면 AI 심판은 더 좋은 답으로 볼까?
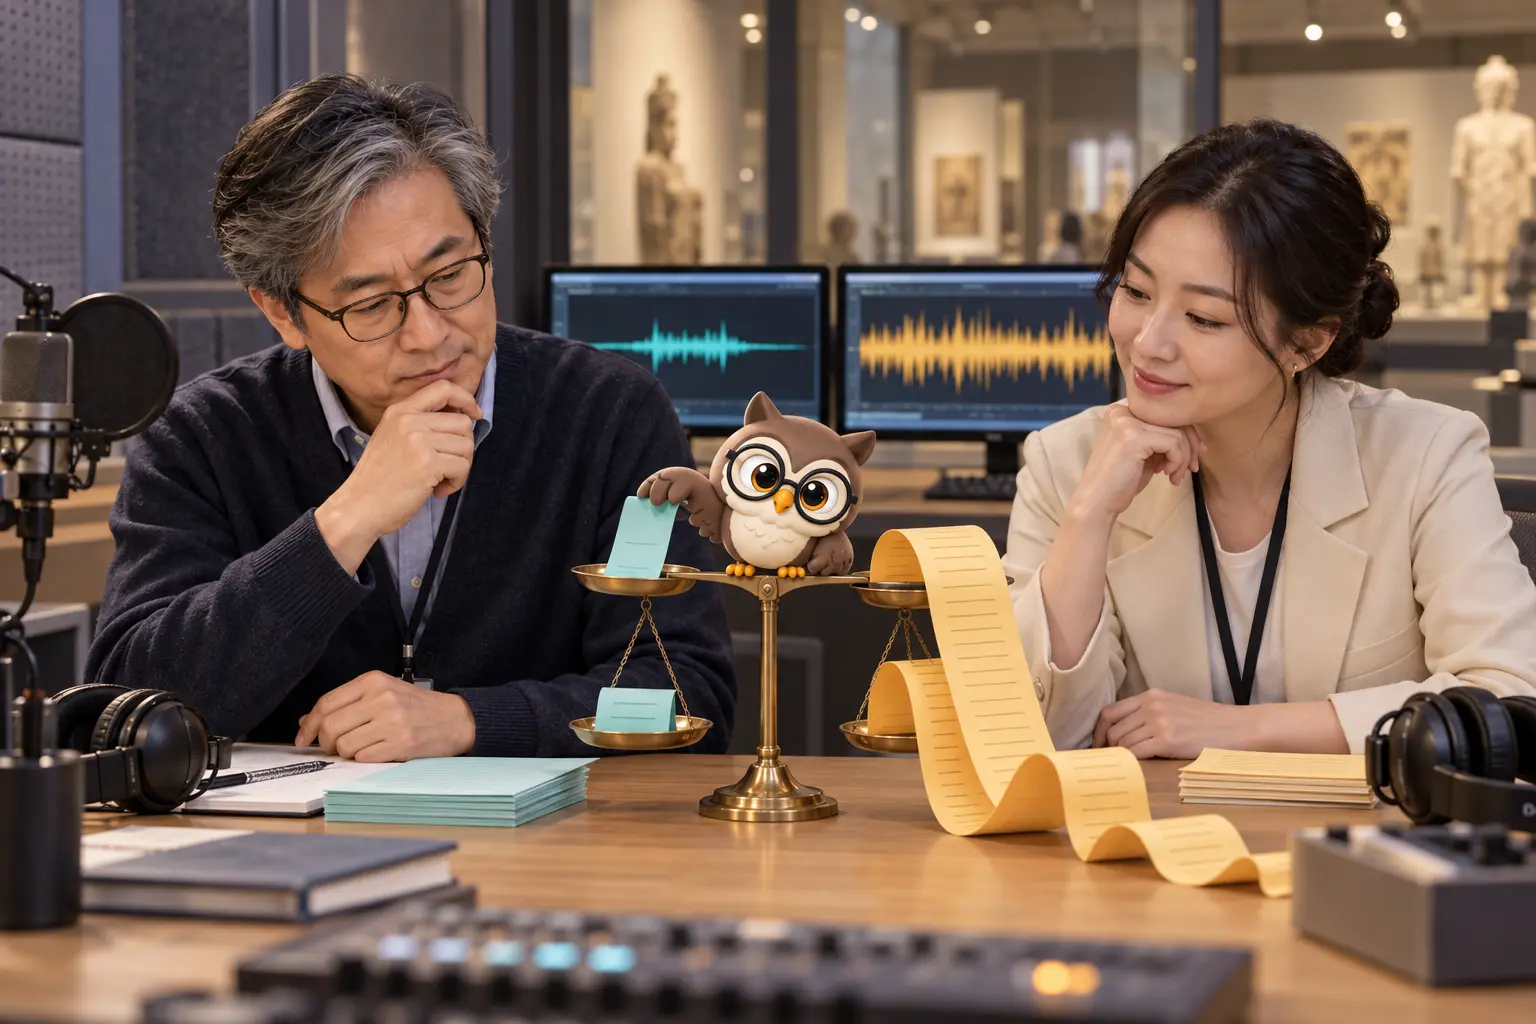
핵심 근거는 2개로 같은 60단어·180단어 답을 길이 보너스 규칙과 근거 루브릭으로 채점해 선택이 뒤집히는 과정을 확인합니다.
게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →
연구와 학습, 시험과 도서를 한곳에서 찾습니다.
검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
관심 주제로 찾아보기
핵심 근거는 2개로 같은 60단어·180단어 답을 길이 보너스 규칙과 근거 루브릭으로 채점해 선택이 뒤집히는 과정을 확인합니다.
같은 열 점수를 50·60·70점에서 자르면 통과율은 70%·40%·20%로 바뀌지만 원래 평균 58점과 사람 사이 거리는 그대로임을 확인합니다.
첫 측정 88 이상만 고르면 처치 없이도 평균이 92에서 86으로 내려가는 예시로, 자연스러운 재측정 변화와 개입 효과를 분리합니다.
중간 상태 복원과 가중치 편집의 결과를 대상 문장·바꿔 쓴 문장·이웃 지식으로 나누어, 국소 성공에서 전체 설명으로 넘어가는 조건을 살핍니다.
검사마다 5%인 오경보 가능성이 여러 검사를 거치며 어떻게 쌓이는지 보고, Bonferroni 조정이 무엇을 보장하고 무엇을 포기하는지 살핍니다.
271–275 / 400편