한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과472건

검색 결과 제목

  1. 241AI가 모를 때 멈추면 더 믿을 수 있을까?
  2. 242전체 80점이면 모든 집단에도 잘한 걸까?
  3. 243AI 시험 문제가 학습 자료와 겹치면 점수를 믿을 수 있을까?
  4. 244AI가 ‘완료했습니다’라고 쓰면 실제 작업도 끝난 걸까?
  5. 245AI 심판은 자기 계열의 답을 더 좋아할까?
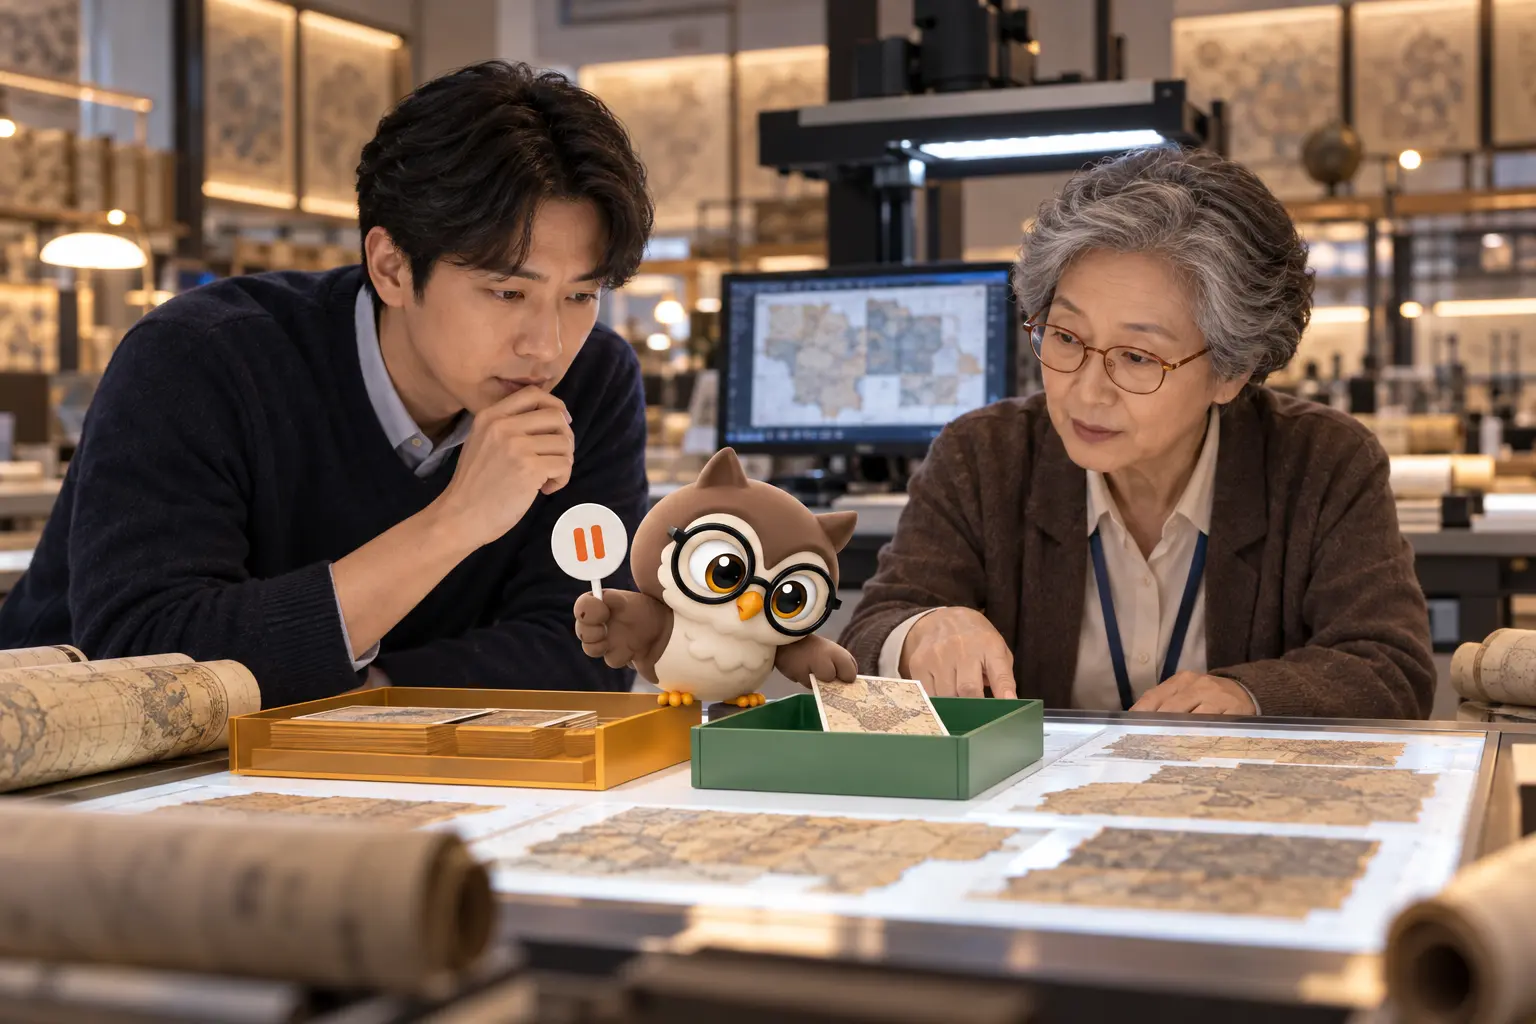
대학 지도 보관소에서 젊은 남성과 은발 여성이 스캔 조각을 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 보류 표식을 들고 지도 카드를 사람 검토 상자로 옮기는 장면

AI가 모를 때 멈추면 더 믿을 수 있을까?

대학 지도 보관소에서 젊은 남성과 은발 여성이 스캔 조각을 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 보류 표식을 들고 지도 카드를 사람 검토 상자로 옮기는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

AI가 모를 때 멈추면 더 믿을 수 있을까?

신뢰도 문턱을 높일수록 응답 범위와 응답한 사례의 오류가 어떻게 함께 달라지는지 계산하고, 보류를 포함한 운영 기준을 세웁니다.
게시 2026-09-13 · 약 14분논리학 학습 글 읽기 →
수족관 운영 전시실에서 여성 해양생물학자와 남성 AI 평가자가 네 환경 패널을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 네 색 토큰을 받쳐 드는 장면

전체 80점이면 모든 집단에도 잘한 걸까?

수족관 운영 전시실에서 여성 해양생물학자와 남성 AI 평가자가 네 환경 패널을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 네 색 토큰을 받쳐 드는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

전체 80점이면 모든 집단에도 잘한 걸까?

평균은 모두 80점이지만 최저 집단은 50점과 78점인 두 모델을 비교해, 전체 점수 뒤의 운영상 약한 구간을 찾습니다.
게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →
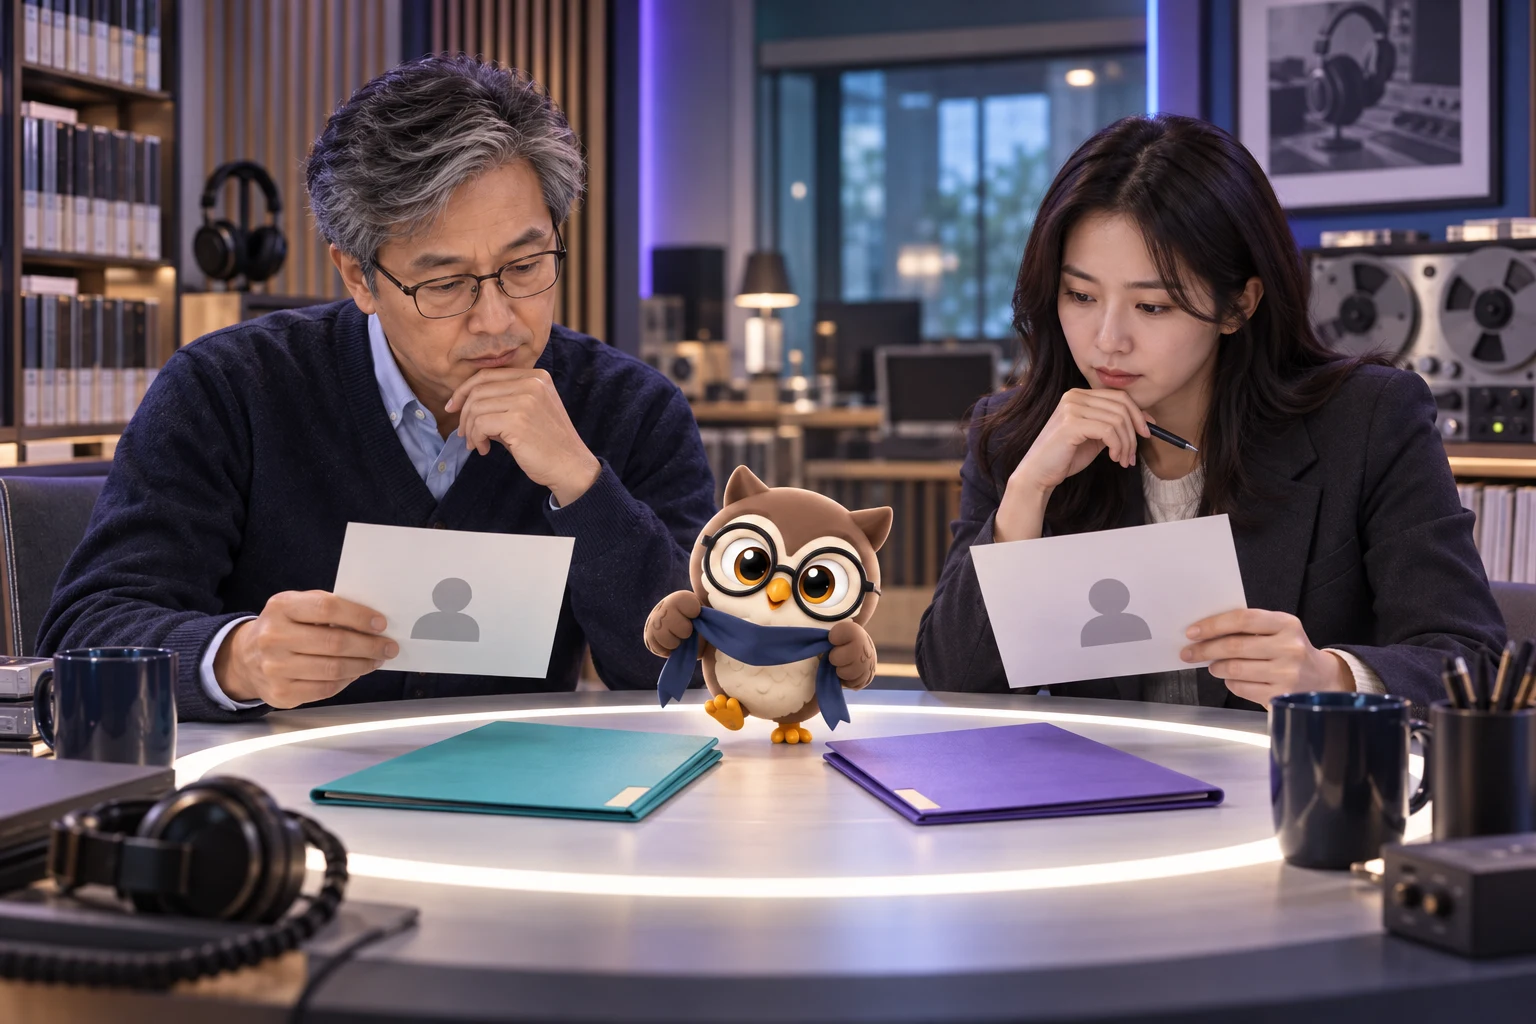
현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면

AI 심판은 자기 계열의 답을 더 좋아할까?

현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

AI 심판은 자기 계열의 답을 더 좋아할까?

내용 조건은 같은 익명 답 A·B를 심판 A·B와 사람 루브릭이 평가할 때 88:78, 77:87, 80:80으로 달라지는 교육용 감사를 수행합니다.

게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →

241–245 / 472편