
논리 규칙 하나씩 시험하면 언어모델의 약점이 더 선명해질까?
LogicBench는 25개 추론 패턴을 명제·1차·비단조 논리로 나눠, 정답률 하나가 숨기는 규칙별 실패를 드러냅니다.
LogicBench: Towards Systematic Evaluation of Logical Reasoning Ability of Large Language Models
게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
연구와 학습, 시험과 도서를 한곳에서 찾습니다.
검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
관심 주제로 찾아보기
LogicBench는 25개 추론 패턴을 명제·1차·비단조 논리로 나눠, 정답률 하나가 숨기는 규칙별 실패를 드러냅니다.
LogicBench: Towards Systematic Evaluation of Logical Reasoning Ability of Large Language Models

작은 문제의 답을 다음 문제에 전달하는 least-to-most 연구는 분해의 개수보다 의존 순서와 분해 자체의 정확성이 중요함을 보여 줍니다.
Least-to-Most Prompting Enables Complex Reasoning in Large Language Models

Baldur는 전체 Isabelle/HOL 증명을 생성한 뒤 오류 메시지로 수리합니다.
Baldur: Whole-Proof Generation and Repair with Large Language Models
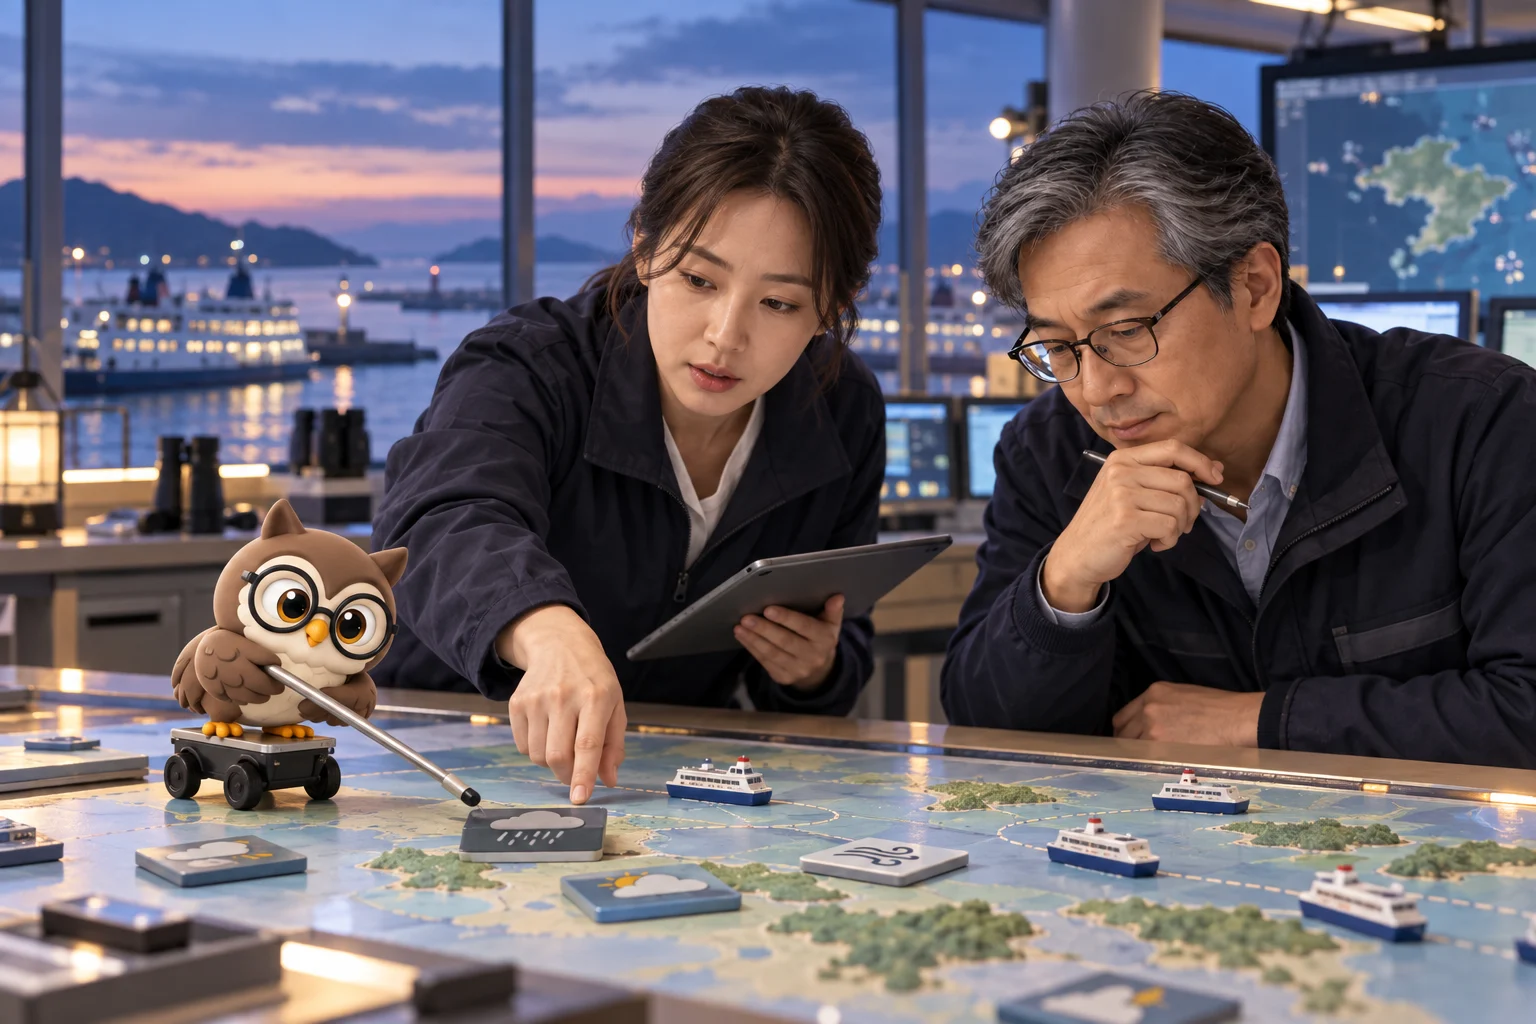
전체 정확도 82%가 66%로 같게 떨어져도 입력 구성 80·20→40·60의 변화와 조건별 정확도 90%→70%의 관계 변화는 다른 진단임을 비교합니다.
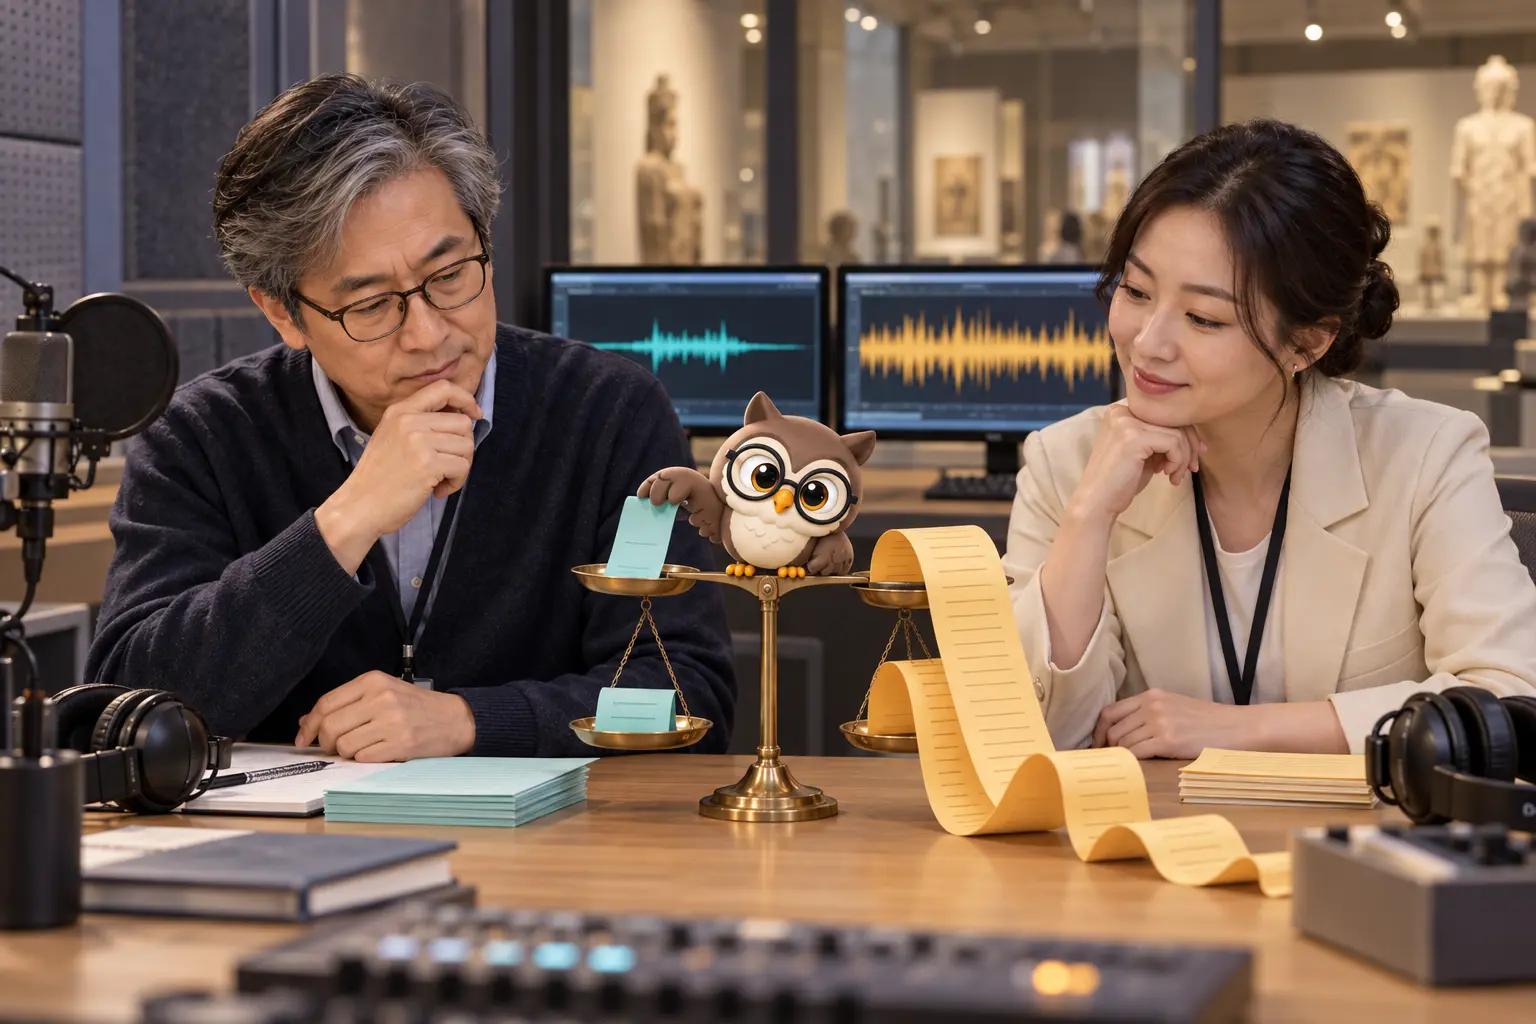
핵심 근거는 2개로 같은 60단어·180단어 답을 길이 보너스 규칙과 근거 루브릭으로 채점해 선택이 뒤집히는 과정을 확인합니다.
16–20 / 27편