
인공지능(AI)가 생각과 행동을 번갈아 하면 무엇이 달라질까?
언어모델이 추론 흔적과 외부 행동·관찰을 번갈아 생성하는 ReAct 연구를 살펴봅니다. 전략과 환경 변화를 바꾸어 검증 가능한 경로를 비교하세요.
ReAct: Synergizing Reasoning and Acting in Language Models
게시 2026-09-20 · 약 9분해외 논리학 연구 해설 읽기 →
연구와 학습, 시험과 도서를 한곳에서 찾습니다.
검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
관심 주제로 찾아보기
언어모델이 추론 흔적과 외부 행동·관찰을 번갈아 생성하는 ReAct 연구를 살펴봅니다. 전략과 환경 변화를 바꾸어 검증 가능한 경로를 비교하세요.
ReAct: Synergizing Reasoning and Acting in Language Models

SATNet은 미분 가능한 근사 MAXSAT 풀이 층을 신경망에 넣어 패리티·스도쿠·시각 스도쿠의 논리 구조를 제한된 감독으로 학습했습니다.
SATNet: Bridging Deep Learning and Logical Reasoning Using a Differentiable Satisfiability Solver

PrOntoQA 분석은 개별 추론 정확성과 여러 갈래에서 목표 경로를 찾는 증명 계획을 분리합니다.
Language Models Are Greedy Reasoners: A Systematic Formal Analysis of Chain-of-Thought
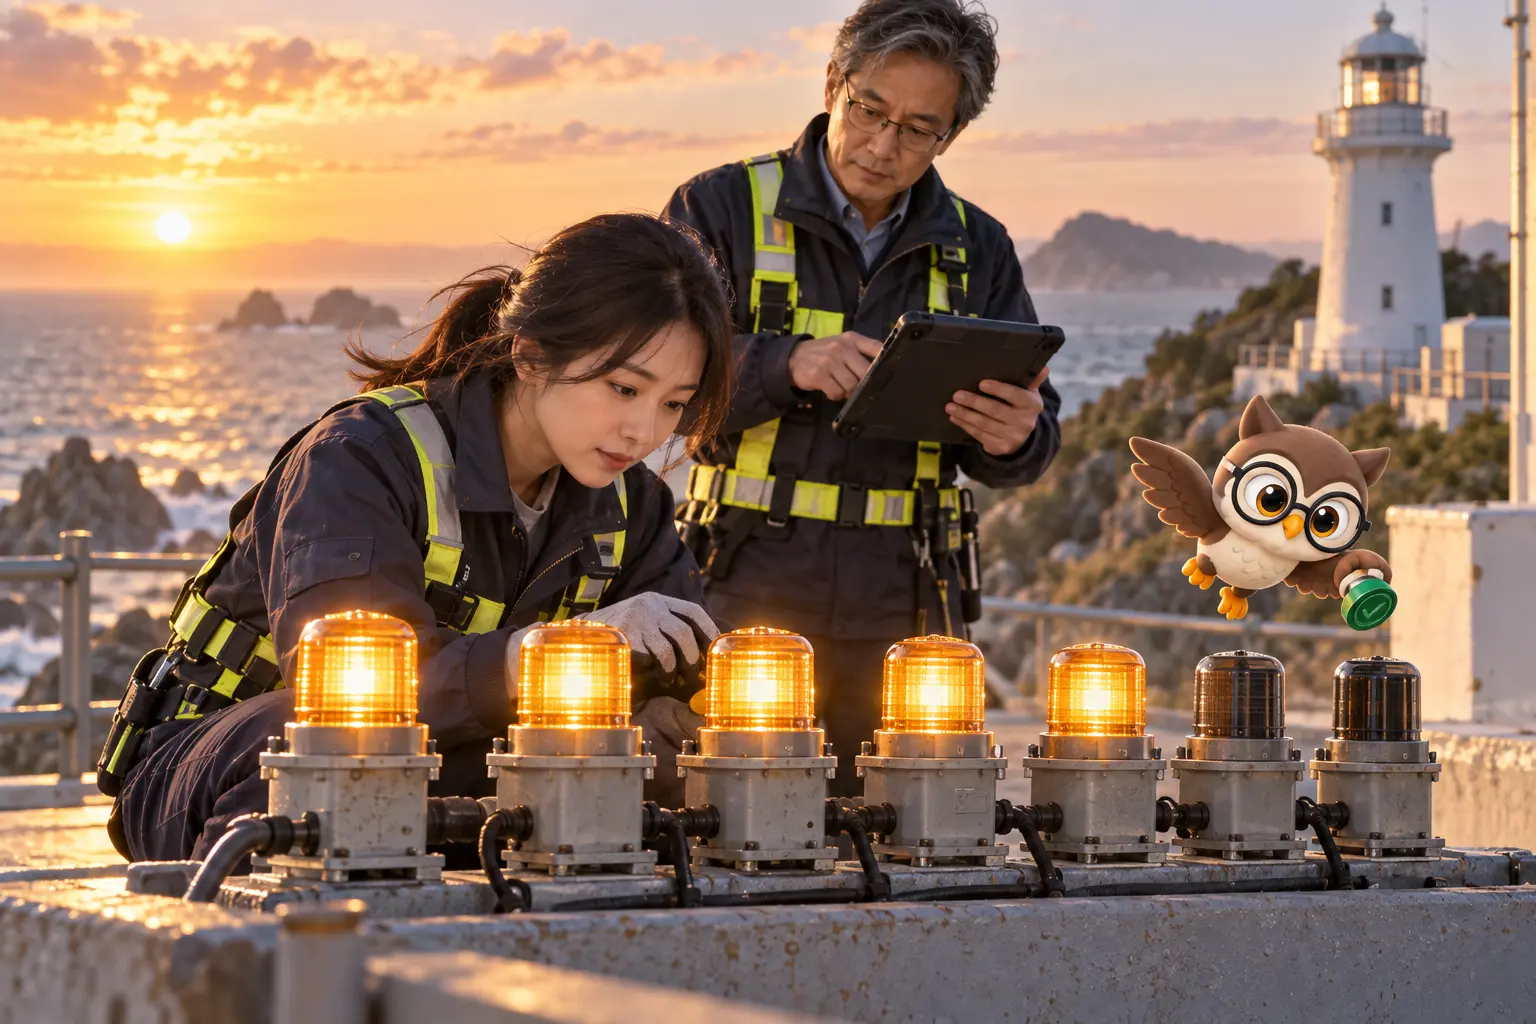
등대 경보판 7개를 바꾸는 가상 작업에서 답변, 도구 결과, 작업 뒤 상태를 분리해 완료의 근거를 판정합니다.
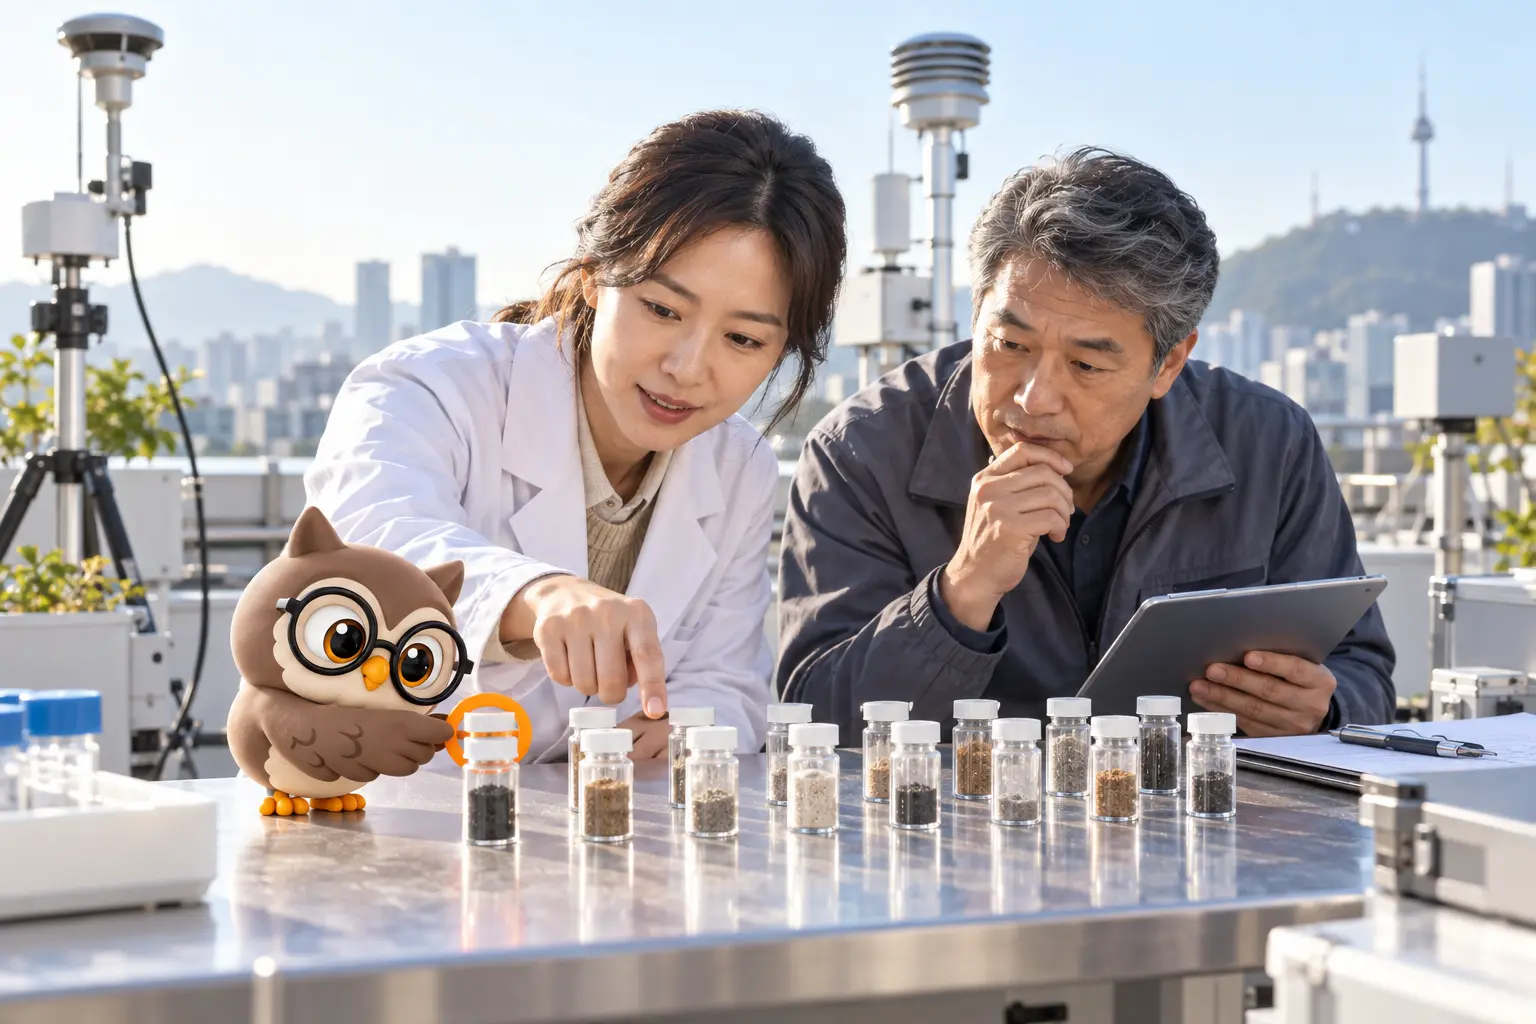
검사마다 5%인 오경보 가능성이 여러 검사를 거치며 어떻게 쌓이는지 보고, Bonferroni 조정이 무엇을 보장하고 무엇을 포기하는지 살핍니다.
6–10 / 17편