한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

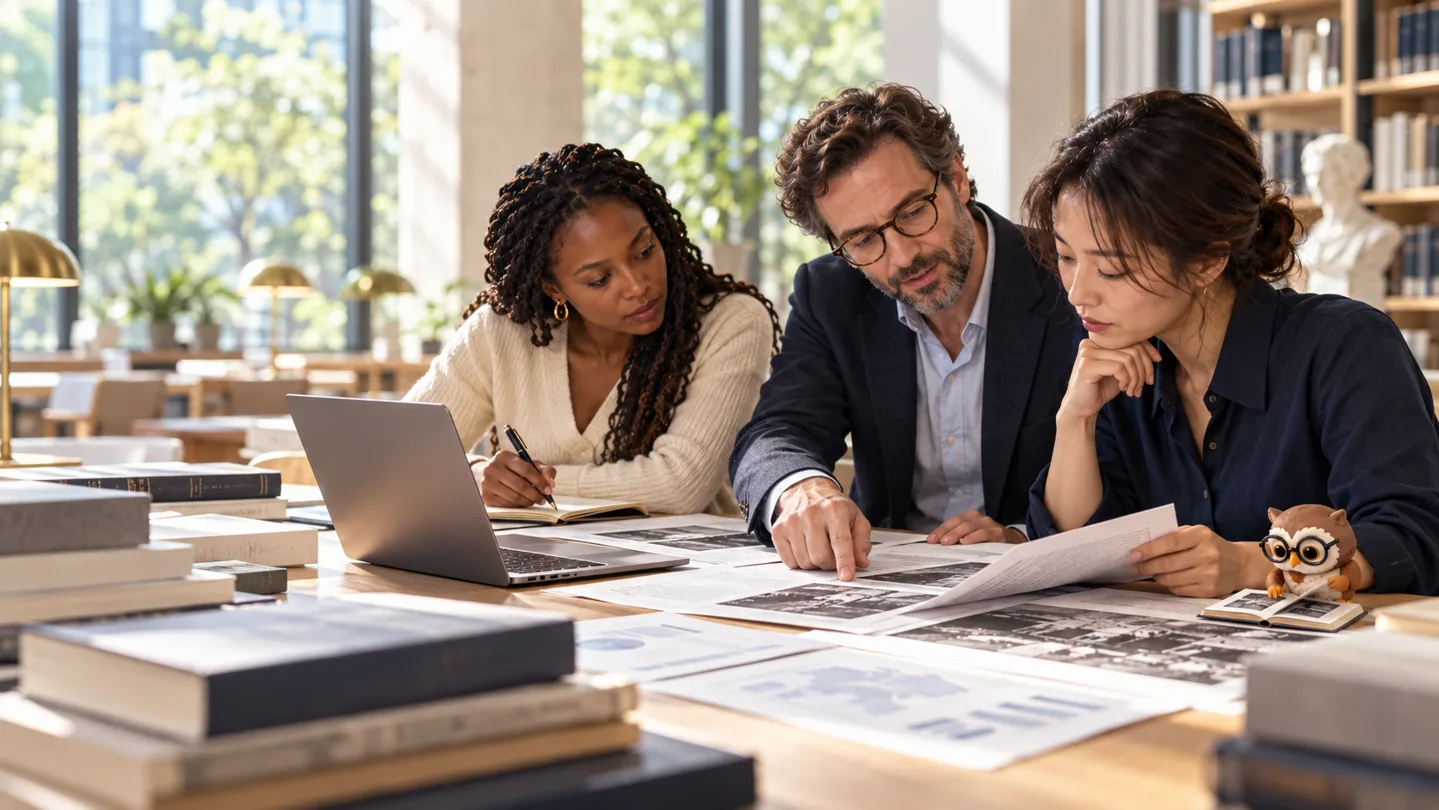
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과38건

검색 결과 제목

  1. 1사전등록과 논문이 다르면, 연구는 약속을 어긴 걸까?
  2. 2언어모형을 크게 만들수록 무엇을 장부에 남겨야 할까?
  3. 3반론을 주고받는 연습이 혼자 쓰는 논증도 바꿀 수 있을까?
  4. 4첫 답이 떠오른 뒤 한 번 멈추면 무엇이 달라질까?
  5. 5인공지능(AI)에게 원칙을 주면 안전한 답이 자동으로 보장될까?
연구 비교The potential of preregistration in psychology: Assessing preregistration producibility and preregistration-study consistency해외 학술 연구
인간의 사고와 추론해외 학술 연구 · 연구 비교 · 일반

사전등록과 논문이 다르면, 연구는 약속을 어긴 걸까?

점검 자료·불일치 유형·질문을 바꾸어 직접 포함되는 연구 수와 허용되는 해석을 비교하고, 변경 자체와 미공개 변경을 구분합니다.

The potential of preregistration in psychology: Assessing preregistration producibility and preregistration-study consistency

게시 2026-10-02 · 약 30분해외 논리학 연구 해설 읽기 →
모델 개발 앞에 자료 출처, 동의, 환경비용, 영향받는 집단의 네 장부가 놓이고 배포 검토로 합류하는 도식.

언어모형을 크게 만들수록 무엇을 장부에 남겨야 할까?

모델 개발 앞에 자료 출처, 동의, 환경비용, 영향받는 집단의 네 장부가 놓이고 배포 검토로 합류하는 도식.
인공지능과 논리해외 학술 연구 · 연구 해설 · 심화

언어모형을 크게 만들수록 무엇을 장부에 남겨야 할까?

Bender 등 연구자들의 ‘확률적 앵무새’ 논문을 통해 대규모 언어모형의 자료 문서화, 환경비용, 편향, 이해관계자 위험을 점검합니다.

On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?

게시 2026-09-28 · 약 12분해외 논리학 연구 해설 읽기 →
주장과 이유에서 동료 반론, 재반박 또는 수정, 개인 논증으로 이어지는 순환 도식.

반론을 주고받는 연습이 혼자 쓰는 논증도 바꿀 수 있을까?

주장과 이유에서 동료 반론, 재반박 또는 수정, 개인 논증으로 이어지는 순환 도식.
논증과 대화해외 학술 연구 · 연구 해설 · 일반

반론을 주고받는 연습이 혼자 쓰는 논증도 바꿀 수 있을까?

Kuhn과 Udell이 학업 위험군 청소년에게 실시한 16회 논증 활동을 읽고, 동료 대화에서 익힌 반론 전략이 개인 논증으로 이어지는 조건을 살펴봅니다.

The Development of Argument Skills

게시 2026-09-25 · 약 10분해외 논리학 연구 해설 읽기 →
첫 반응에서 값 대입 검산을 거쳐 조건에 맞는 수정 답으로 이동하는 세 단계 흐름도.

첫 답이 떠오른 뒤 한 번 멈추면 무엇이 달라질까?

첫 반응에서 값 대입 검산을 거쳐 조건에 맞는 수정 답으로 이동하는 세 단계 흐름도.
인간의 사고와 추론해외 학술 연구 · 연구 해설 · 일반

첫 답이 떠오른 뒤 한 번 멈추면 무엇이 달라질까?

Frederick의 인지성찰검사가 즉각 떠오르는 답을 억제하는 성향을 어떻게 측정했는지 살피고, 정답 수와 사고 과정을 구분합니다.

Cognitive Reflection and Decision Making

게시 2026-09-24 · 약 9분해외 논리학 연구 해설 읽기 →
초안에서 원칙 비판과 수정으로 이어지는 지도학습 단계, 응답 비교에서 선호모형과 강화학습으로 이어지는 단계를 나눈 절차도.

인공지능(AI)에게 원칙을 주면 안전한 답이 자동으로 보장될까?

초안에서 원칙 비판과 수정으로 이어지는 지도학습 단계, 응답 비교에서 선호모형과 강화학습으로 이어지는 단계를 나눈 절차도.
인공지능과 논리해외 학술 연구 · 연구 해설 · 심화

인공지능(AI)에게 원칙을 주면 안전한 답이 자동으로 보장될까?

Constitutional AI 공개본의 비판·수정과 AI 피드백 강화학습 절차를 구분하고, 원칙 선택과 평가의 남은 한계를 살핍니다.

Constitutional AI: Harmlessness from AI Feedback

게시 2026-09-23 · 약 10분해외 논리학 연구 해설 읽기 →

1–5 / 38편