한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

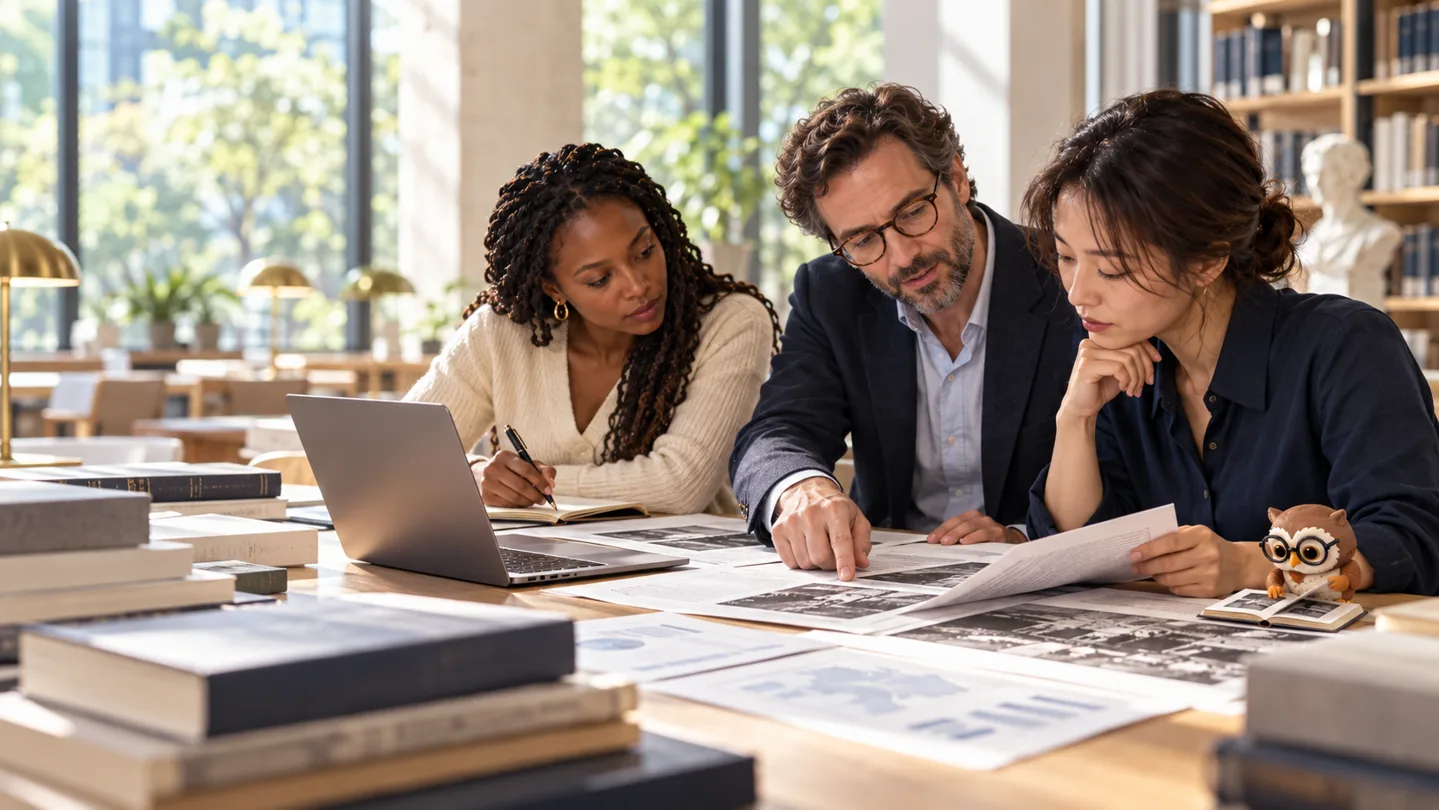
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과74건

검색 결과 제목

  1. 1“키가 크고 빠르다”의 정도는 어떻게 계산할까요?
  2. 2다시 읽기·개념지도·기억해 내기 연구는 같은 질문에 답할까
  3. 3‘휴대전화 사용시간’ 설문과 로그가 다르면 어느 쪽 연구를 믿어야 할까?
  4. 4같은 수치를 길이와 각도로 보여 주면 어느 쪽이 더 정확할까?
  5. 5인공지능(AI)에게 같은 질문을 여러 번 하면 꾸며낸 사실을 찾을 수 있을까?
논문 대담Petr Hájek, What is Mathematical Fuzzy Logic (2006)Fuzzy Sets and Systems, 157(5), 597–603
논리의 기초와 역사해외 학술 연구 · 논문 대담 · 심화

“키가 크고 빠르다”의 정도는 어떻게 계산할까요?

어떤 대상이 “키가 크다”에 해당하는 정도를 0.7, “빠르다”에 해당하는 정도를 0.6으로 정했다고 합시다. 두 조건을 함께 말할 때 결과는 얼마일까요? 페트르 하예크의 논문을 따라 계산 규칙과 추론의 관계를 살펴봅니다. 이 수치는 계산을 설명하기 위해 정한 예입니다.

Petr Hájek, What is Mathematical Fuzzy Logic (2006)

연구 비교Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention해외 학술 연구
논리교육과 평가해외 학술 연구 · 연구 비교 · 일반

다시 읽기·개념지도·기억해 내기 연구는 같은 질문에 답할까

세 연구의 대상·비교 활동·검사 시점·결과 유형을 골라 포함 연구와 허용되는 해석을 바꾸고, 서로 다른 설계를 한 수치로 섞지 않는다.

Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention

게시 2026-10-06 · 약 24분해외 논리학 연구 해설 읽기 →
연구 비교Measuring Mobile Phone Use: Self-Report Versus Log Data해외 학술 연구
인간의 사고와 추론해외 학술 연구 · 연구 비교 · 일반

‘휴대전화 사용시간’ 설문과 로그가 다르면 어느 쪽 연구를 믿어야 할까?

측정 행동·비교 대상·표본을 선택해 포함 연구 수, 설문–로그 결과와 한계, 허용되는 해석을 함께 바꿉니다.

Measuring Mobile Phone Use: Self-Report Versus Log Data

게시 2026-10-04 · 약 32분해외 논리학 연구 해설 읽기 →
같은 62와 79를 공통 축의 점, 막대 길이, 원의 각도로 나란히 표현하고 비교 과제를 표시한 도식.

같은 수치를 길이와 각도로 보여 주면 어느 쪽이 더 정확할까?

같은 62와 79를 공통 축의 점, 막대 길이, 원의 각도로 나란히 표현하고 비교 과제를 표시한 도식.
다이어그램과 시각추론해외 학술 연구 · 연구 해설 · 심화

같은 수치를 길이와 각도로 보여 주면 어느 쪽이 더 정확할까?

Cleveland와 McGill의 그래프 지각 실험을 통해 공통 축의 위치, 길이, 각도, 면적이 서로 다른 비교 정확도를 낳는 이유를 살펴봅니다.

Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods

게시 2026-09-28 · 약 12분해외 논리학 연구 해설 읽기 →
하나의 질문에서 나온 네 가상 답변을 서로 비교해 일치와 충돌을 표시한 행렬.

인공지능(AI)에게 같은 질문을 여러 번 하면 꾸며낸 사실을 찾을 수 있을까?

하나의 질문에서 나온 네 가상 답변을 서로 비교해 일치와 충돌을 표시한 행렬.
인공지능과 논리해외 학술 연구 · 연구 해설 · 심화

인공지능(AI)에게 같은 질문을 여러 번 하면 꾸며낸 사실을 찾을 수 있을까?

SelfCheckGPT가 검은상자 생성 모델의 여러 표본 사이 불일치를 이용해 환각을 탐지한 방법을 읽고, 일관성과 사실성을 구분합니다.

SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models

게시 2026-09-25 · 약 11분해외 논리학 연구 해설 읽기 →

1–5 / 74편