한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과70건

검색 결과 제목

  1. 1같은 질문을 다시 하면 AI도 같은 답을 고를까?
  2. 2인공지능(AI)가 확신이 낮은 답을 보류하면 정확도는 어떻게 달라질까?
  3. 3긴 문맥을 읽는 인공지능(AI)는 가운데 근거도 똑같이 찾을까?
  4. 4AI가 여러 번 시도해 하나를 맞히면 한 번의 실력도 같은 걸까?
  5. 5인공지능(AI)가 식을 프로그램으로 쓰면 계산 실수는 줄어들까?
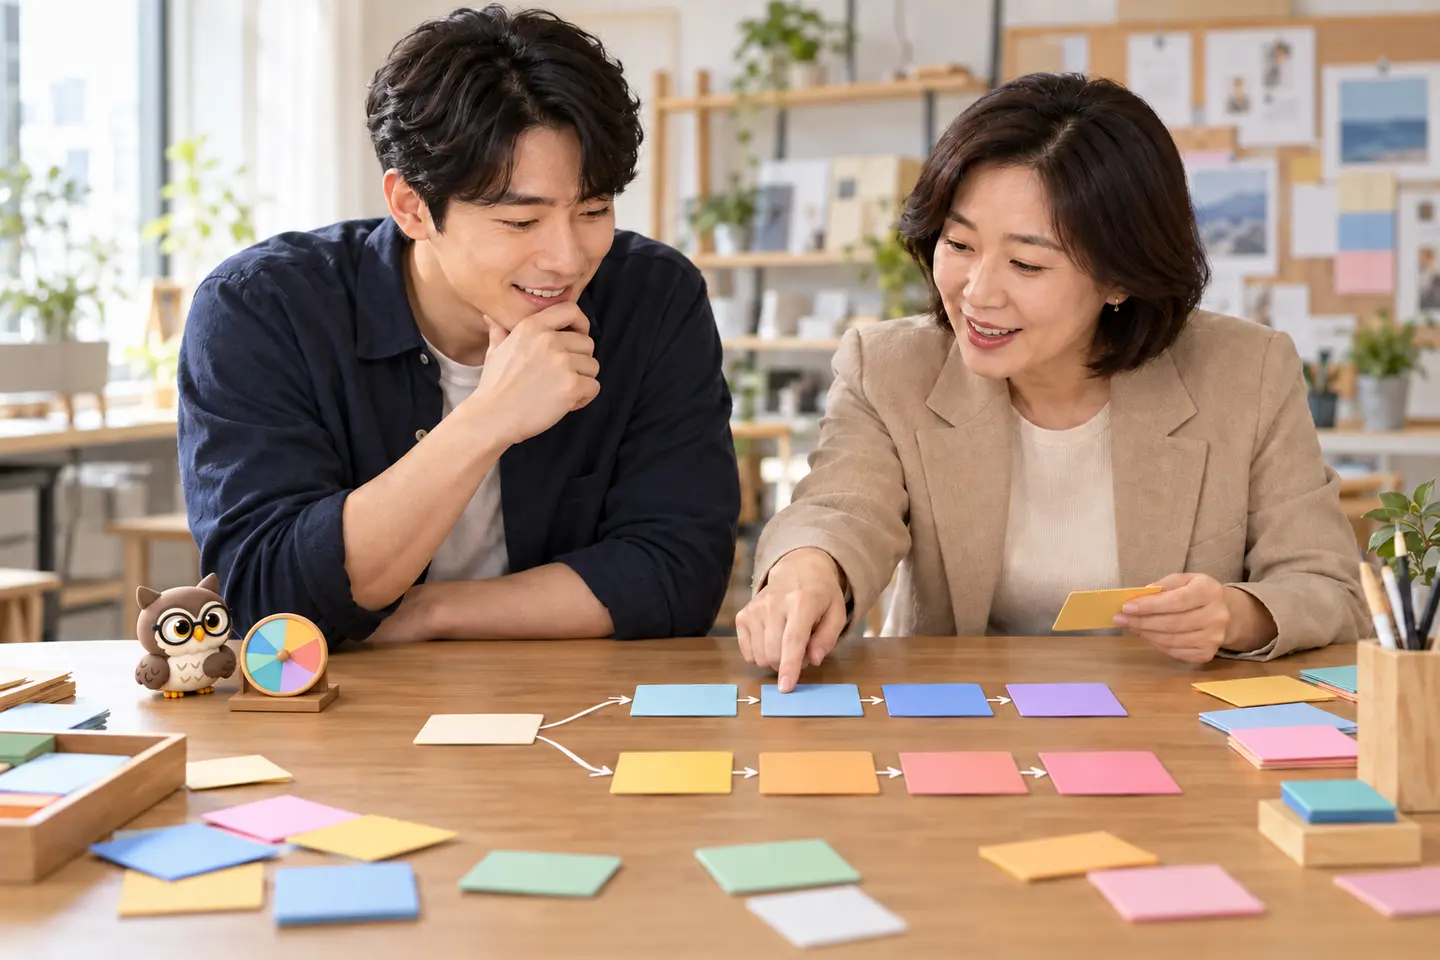
밝은 작업실에서 성인 두 명이 여러 갈래의 답 후보 카드를 비교하고 작은 공식 갈색 안경 올빼미가 선택 바퀴를 돌리는 장면

같은 질문을 다시 하면 AI도 같은 답을 고를까?

밝은 작업실에서 성인 두 명이 여러 갈래의 답 후보 카드를 비교하고 작은 공식 갈색 안경 올빼미가 선택 바퀴를 돌리는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 입문

같은 질문을 다시 하면 AI도 같은 답을 고를까?

후보 점수가 같아도 선택 규칙의 무작위성에 따라 실행 결과가 달라질 수 있습니다. 온도·시드·횟수를 바꿔 분포와 재현성을 확인합니다.

게시 2026-10-04 · 약 13분논리학 학습 글 읽기 →
가상 예측 카드가 확신 기준을 통과하면 답변으로, 통과하지 못하면 보류로 갈라지는 흐름도

인공지능(AI)가 확신이 낮은 답을 보류하면 정확도는 어떻게 달라질까?

가상 예측 카드가 확신 기준을 통과하면 답변으로, 통과하지 못하면 보류로 갈라지는 흐름도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 확신이 낮은 답을 보류하면 정확도는 어떻게 달라질까?

AI가 낮은 확신의 답을 보류할 때 답한 범위와 정답률이 함께 어떻게 바뀌는지 살펴보고, 선택된 일부의 성능을 전체 신뢰성과 혼동하지 않는 법을 익힙니다.

Language Models (Mostly) Know What They Know

게시 2026-10-02 · 약 11분해외 논리학 연구 해설 읽기 →
긴 문맥의 처음과 끝에서는 성능이 높고 가운데 근거에서는 낮아지는 U자형 위치 민감성 곡선

긴 문맥을 읽는 인공지능(AI)는 가운데 근거도 똑같이 찾을까?

긴 문맥의 처음과 끝에서는 성능이 높고 가운데 근거에서는 낮아지는 U자형 위치 민감성 곡선
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

긴 문맥을 읽는 인공지능(AI)는 가운데 근거도 똑같이 찾을까?

긴 문맥 모델도 근거 위치에 따라 성능이 달라졌습니다. 문서 수와 위치를 바꾸는 교육 모형으로 강건성을 점검합니다.

Lost in the Middle: How Language Models Use Long Contexts
게시 2026-09-29 · 약 8분해외 논리학 연구 해설 읽기 →
문장제에서 변수와 식을 추출해 제한된 프로그램을 실행하고 의미 검산으로 돌아가는 네 단계 흐름도.

인공지능(AI)가 식을 프로그램으로 쓰면 계산 실수는 줄어들까?

문장제에서 변수와 식을 추출해 제한된 프로그램을 실행하고 의미 검산으로 돌아가는 네 단계 흐름도.
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 식을 프로그램으로 쓰면 계산 실수는 줄어들까?

Program of Thoughts는 언어모델이 계산까지 문장으로 이어 쓰는 대신, 추론을 실행 가능한 프로그램으로 표현하고 계산은 외부 실행기에 맡깁니다.

Program of Thoughts Prompting: Disentangling Computation from Reasoning for Numerical Reasoning Tasks

게시 2026-09-22 · 약 9분해외 논리학 연구 해설 읽기 →

1–5 / 70편