한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

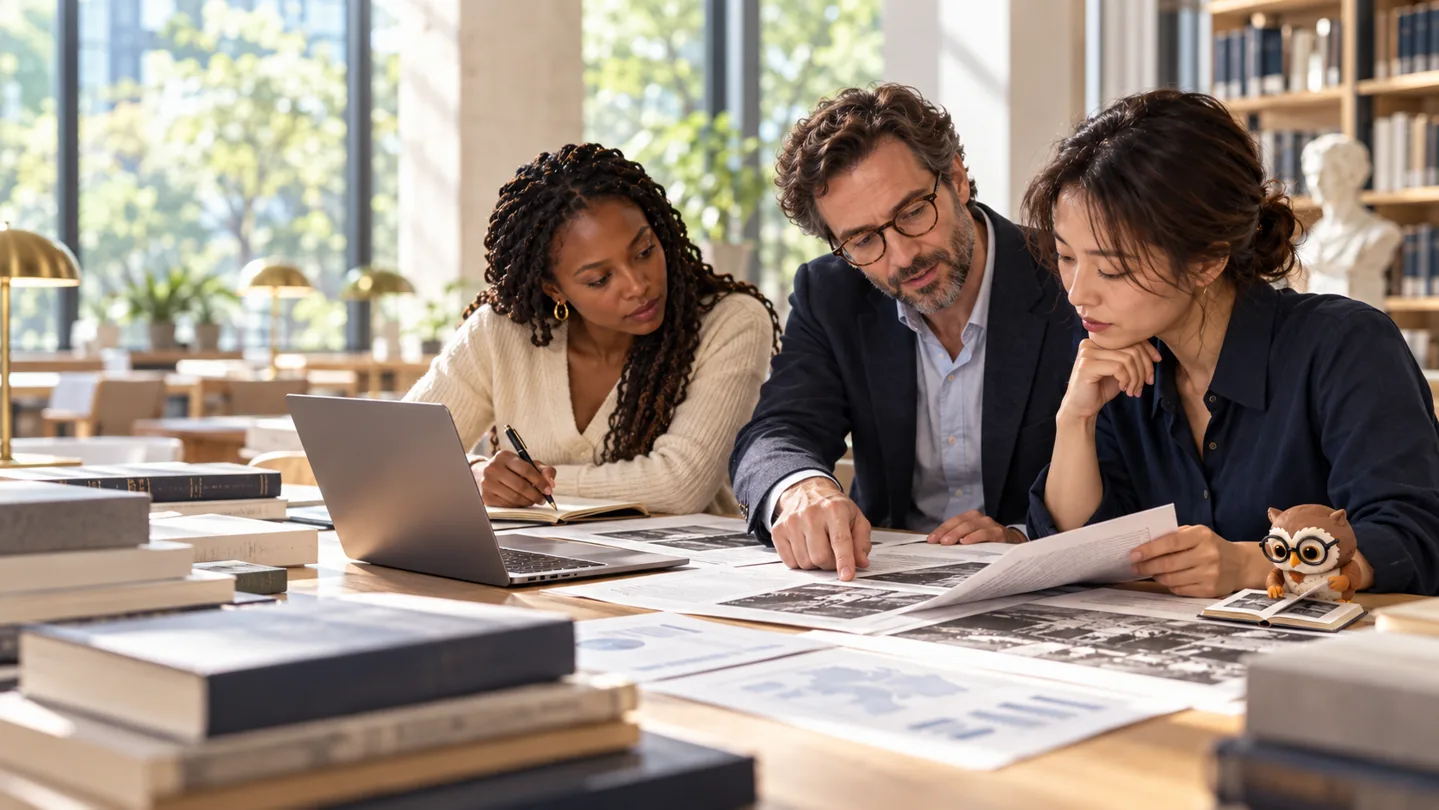
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과34건

검색 결과 제목

  1. 16큰 정리를 작은 목표로 나누면 인공지능(AI) 증명은 더 강해질까?
  2. 17인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?
  3. 18쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?
  4. 19증명을 한 번에 쓰고 오류 메시지로 고치면 될까?
  5. 20입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?
큰 정리를 작은 목표로 나누면 AI 증명은 더 강해질까?의 질문, 방법, 결과와 적용 범위를 세 단계 카드로 정리한 교육용 도식

큰 정리를 작은 목표로 나누면 인공지능(AI) 증명은 더 강해질까?

큰 정리를 작은 목표로 나누면 AI 증명은 더 강해질까?의 질문, 방법, 결과와 적용 범위를 세 단계 카드로 정리한 교육용 도식
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

큰 정리를 작은 목표로 나누면 인공지능(AI) 증명은 더 강해질까?

DeepSeek-Prover-V2는 비형식 풀이를 하위 목표로 재귀 분해해 형식 추론의 학습 자료와 보상 구조를 만든다.

DeepSeek-Prover-V2: Advancing Formal Mathematical Reasoning via Reinforcement Learning for Subgoal Decomposition

게시 2026-09-13 · 약 11분해외 논리학 연구 해설 읽기 →
원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

AlphaProof는 Lean 검증 환경, 대규모 자기학습과 문제별 시험시점 강화학습을 결합해 2024 IMO 비기하 5문제 중 3문제를 풀었지만 막대한 계산비용과 형식화 범위가 제한입니다.

Olympiad-level Formal Mathematical Reasoning with Reinforcement Learning

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
두 개의 쉬운 부등식 조각이 재작성과 합성 노드를 지나 Lean 목표로 가며 중간 합성 지점에 병목 표시가 있는 흐름도

쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?

두 개의 쉬운 부등식 조각이 재작성과 합성 노드를 지나 Lean 목표로 가며 중간 합성 지점에 병목 표시가 있는 흐름도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?

Ineq-Comp v2를 바탕으로 익숙한 부등식의 변수 복제·대수 재작성·다단계 합성이 현재 Lean 증명 모델의 구성적 일반화를 크게 흔드는지 살펴봅니다.

Ineq-Comp: Benchmarking Human-Intuitive Compositional Reasoning in Automated Theorem Proving on Inequalities

게시 2026-09-13 · 약 10분해외 논리학 연구 해설 읽기 →
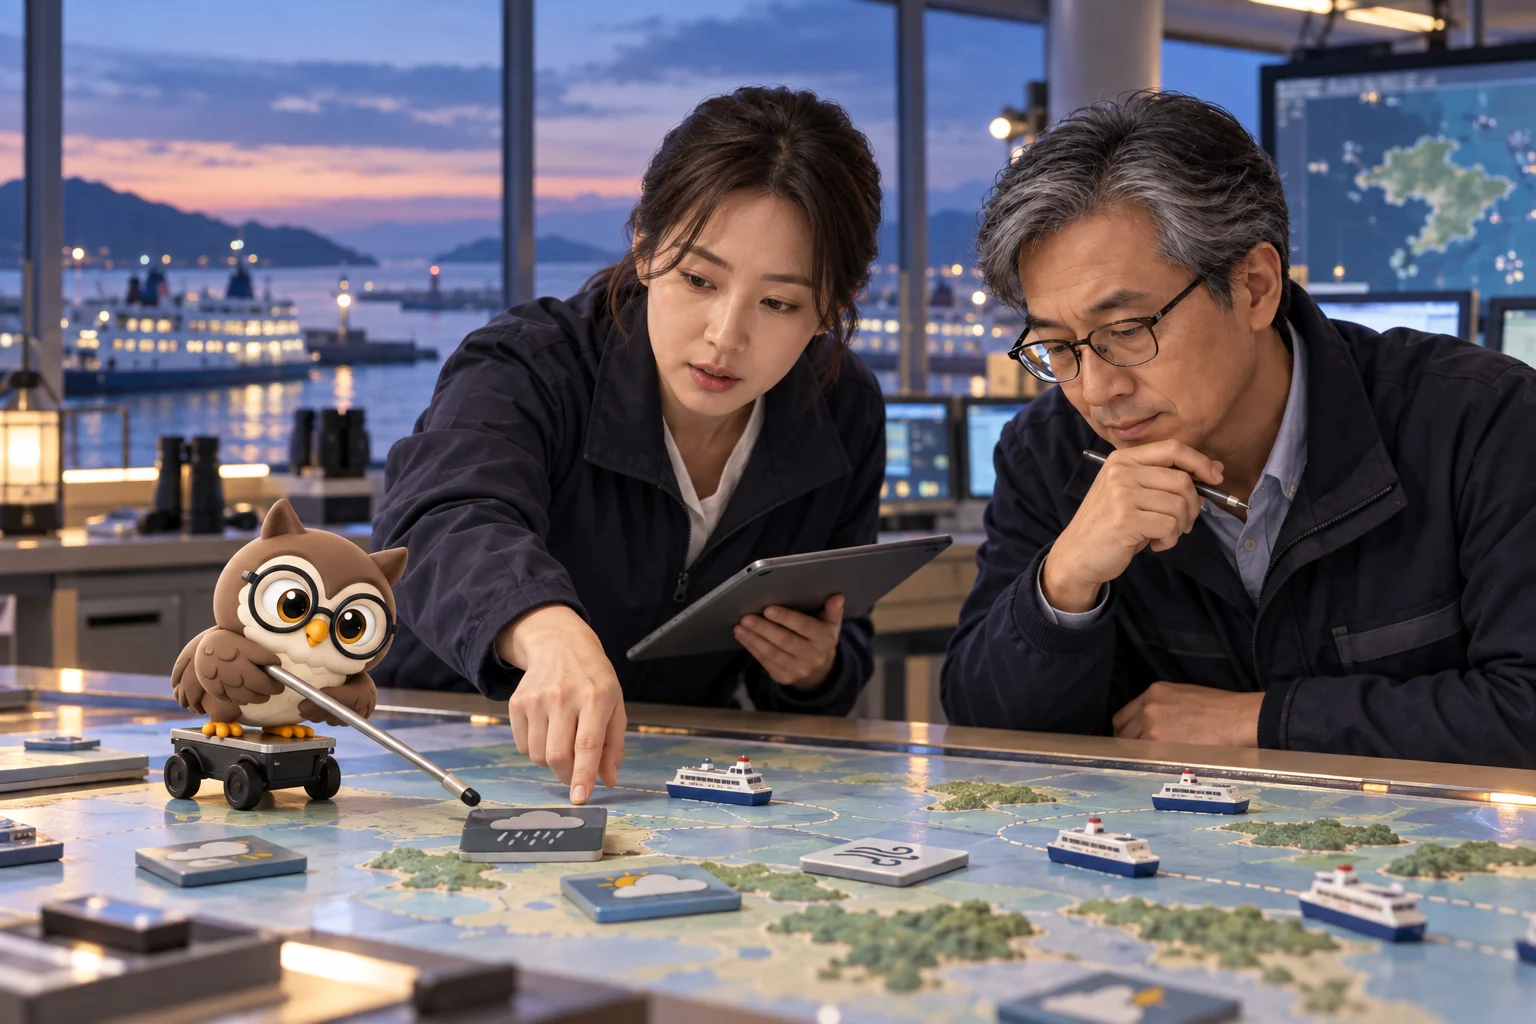
해질녘 연안 여객선 운영실에서 여성 운영자와 남성 운영자가 지도와 문서 표식을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 지시봉을 들고 참여하는 장면

입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?

해질녘 연안 여객선 운영실에서 여성 운영자와 남성 운영자가 지도와 문서 표식을 비교하고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 지시봉을 들고 참여하는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

입력 분포가 바뀌면 AI 오류도 같은 방식으로 늘어날까?

전체 정확도 82%가 66%로 같게 떨어져도 입력 구성 80·20→40·60의 변화와 조건별 정확도 90%→70%의 관계 변화는 다른 진단임을 비교합니다.

게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →

16–20 / 34편