한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

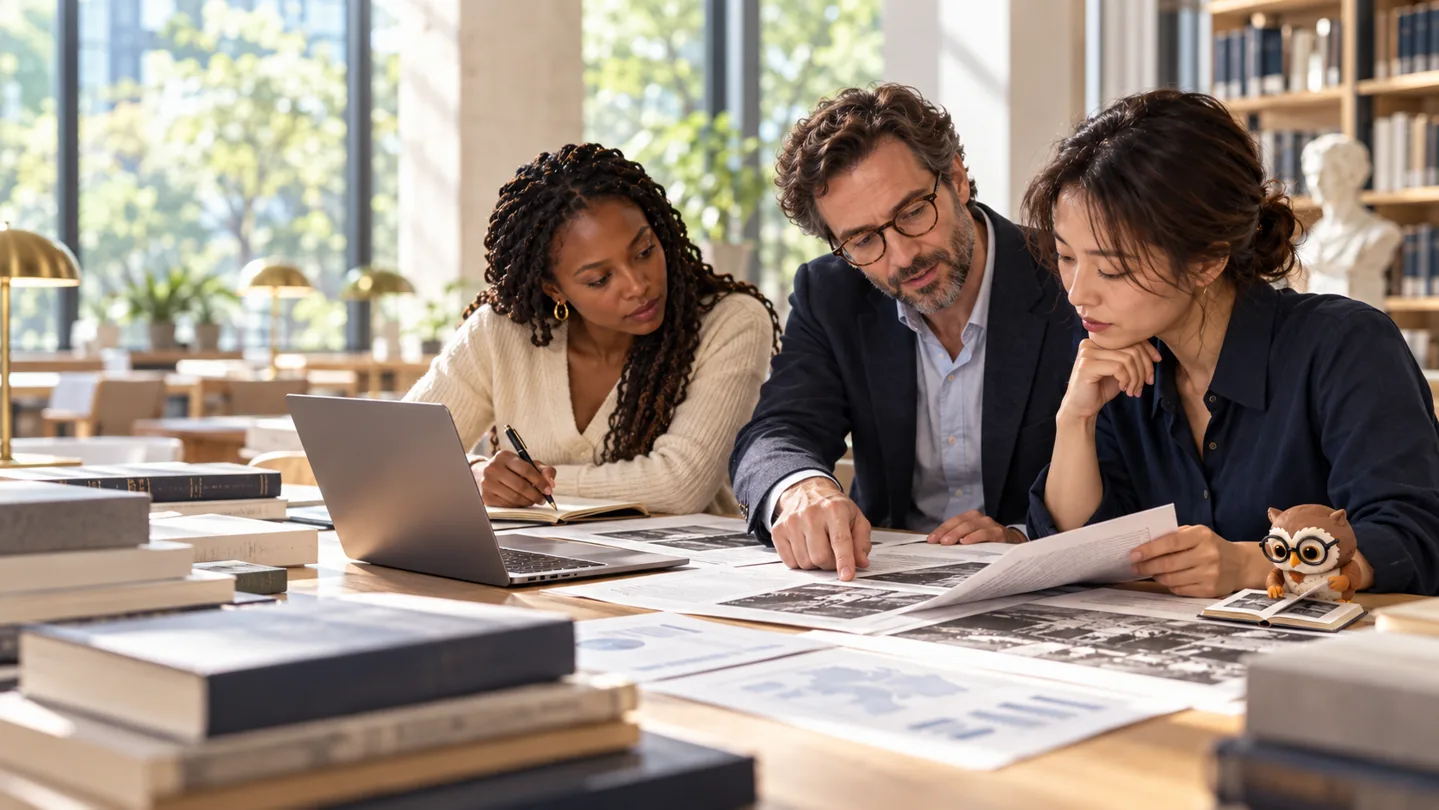
세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과16건

검색 결과 제목

  1. 6증명 단계를 거의 다 맞혀도 전체 정리는 못 풀 수 있을까?
  2. 7인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?
  3. 8검색 문서 속 명령을 AI가 따라도 될까?
  4. 9보상 점수가 높으면 AI가 목적도 잘 따른 걸까?
  5. 10인공지능(AI)가 쓴 풀이가 실제 판단 과정을 그대로 보여 줄까?
열 개의 증명 단계 중 아홉 단계가 초록색으로 성공해도 한 중간 단계의 실패가 최종 정리 실패로 이어지는 사슬 도식.

증명 단계를 거의 다 맞혀도 전체 정리는 못 풀 수 있을까?

열 개의 증명 단계 중 아홉 단계가 초록색으로 성공해도 한 중간 단계의 실패가 최종 정리 실패로 이어지는 사슬 도식.
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

증명 단계를 거의 다 맞혀도 전체 정리는 못 풀 수 있을까?

Lean Meets Theoretical Computer Science는 매개변수화한 Busy Beaver·혼합 불 대수 문제로 단계 성공률과 전체 증명 성공률의 큰 차이를 드러낸다.

Lean Meets Theoretical Computer Science: Scalable Synthesis of Theorem Proving Challenges in Formal-Informal Pairs

게시 2026-09-13 · 약 8분해외 논리학 연구 해설 읽기 →
원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

AlphaProof는 Lean 검증 환경, 대규모 자기학습과 문제별 시험시점 강화학습을 결합해 2024 IMO 비기하 5문제 중 3문제를 풀었지만 막대한 계산비용과 형식화 범위가 제한입니다.

Olympiad-level Formal Mathematical Reasoning with Reinforcement Learning

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
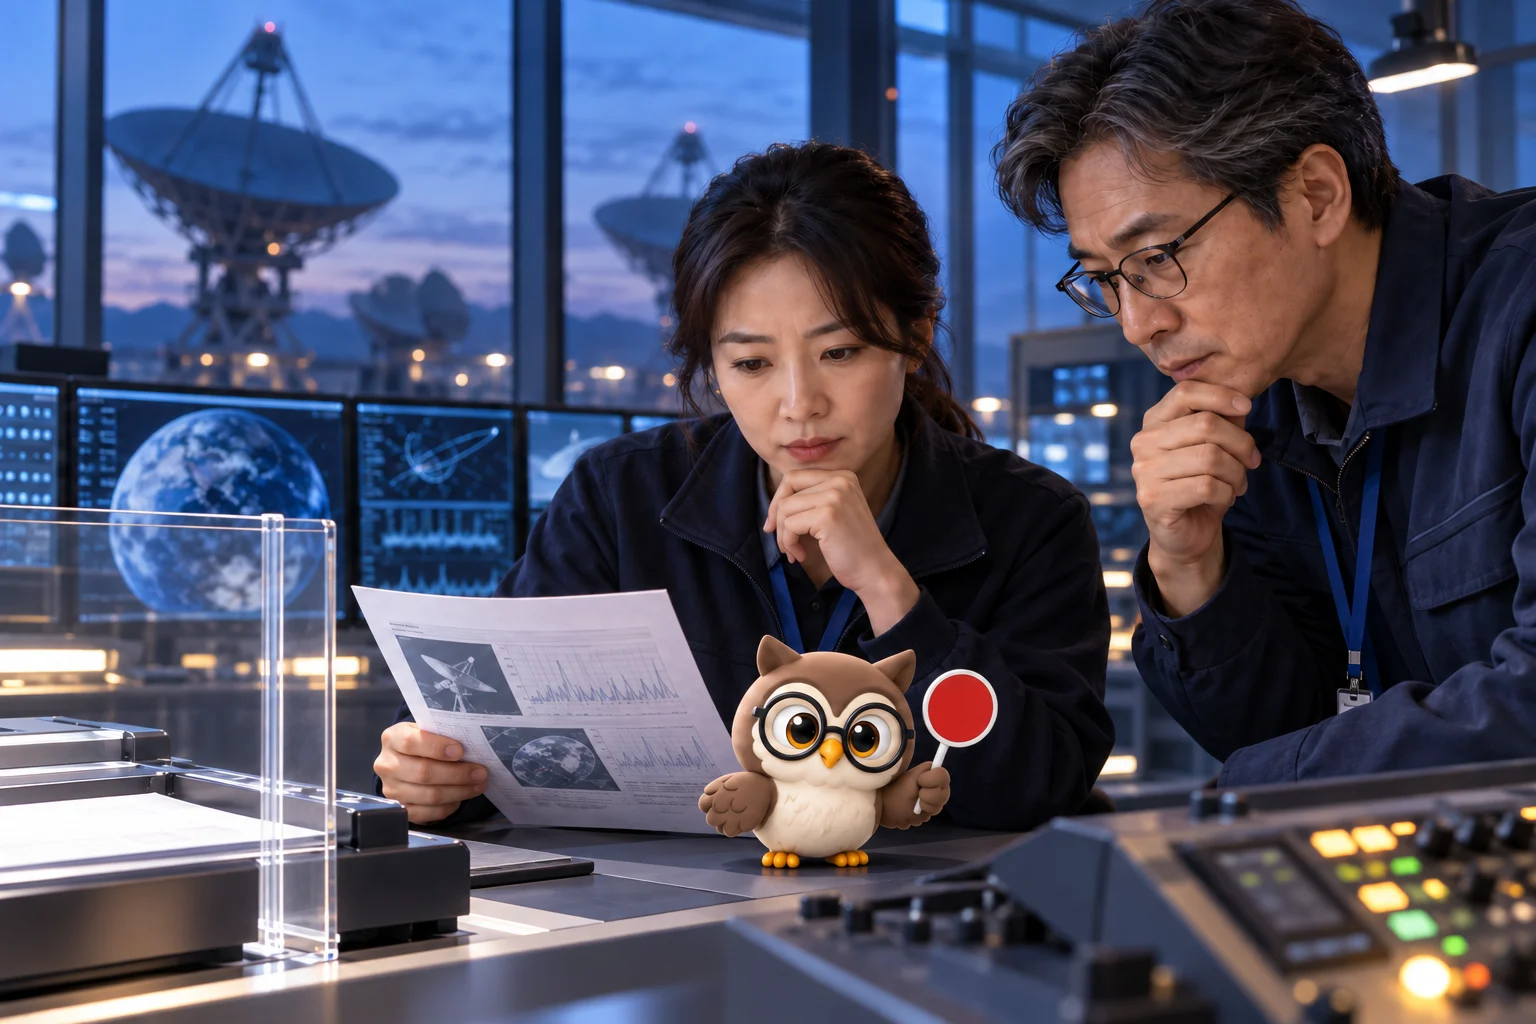
푸른 저녁 위성 관제실에서 여성 보안 기술자와 남성 분석가가 외부 보고서를 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 두 사람 사이에서 붉은 정지 표식을 드는 장면

검색 문서 속 명령을 AI가 따라도 될까?

푸른 저녁 위성 관제실에서 여성 보안 기술자와 남성 분석가가 외부 보고서를 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 두 사람 사이에서 붉은 정지 표식을 드는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

검색 문서 속 명령을 AI가 따라도 될까?

요약하려고 가져온 문서의 ‘승인 상태를 바꿔라’는 문장을 지시가 아닌 자료로 표시하고, 읽기 전용 권한으로 행동 경로를 차단하는 두 겹 방어를 비교합니다.

게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →
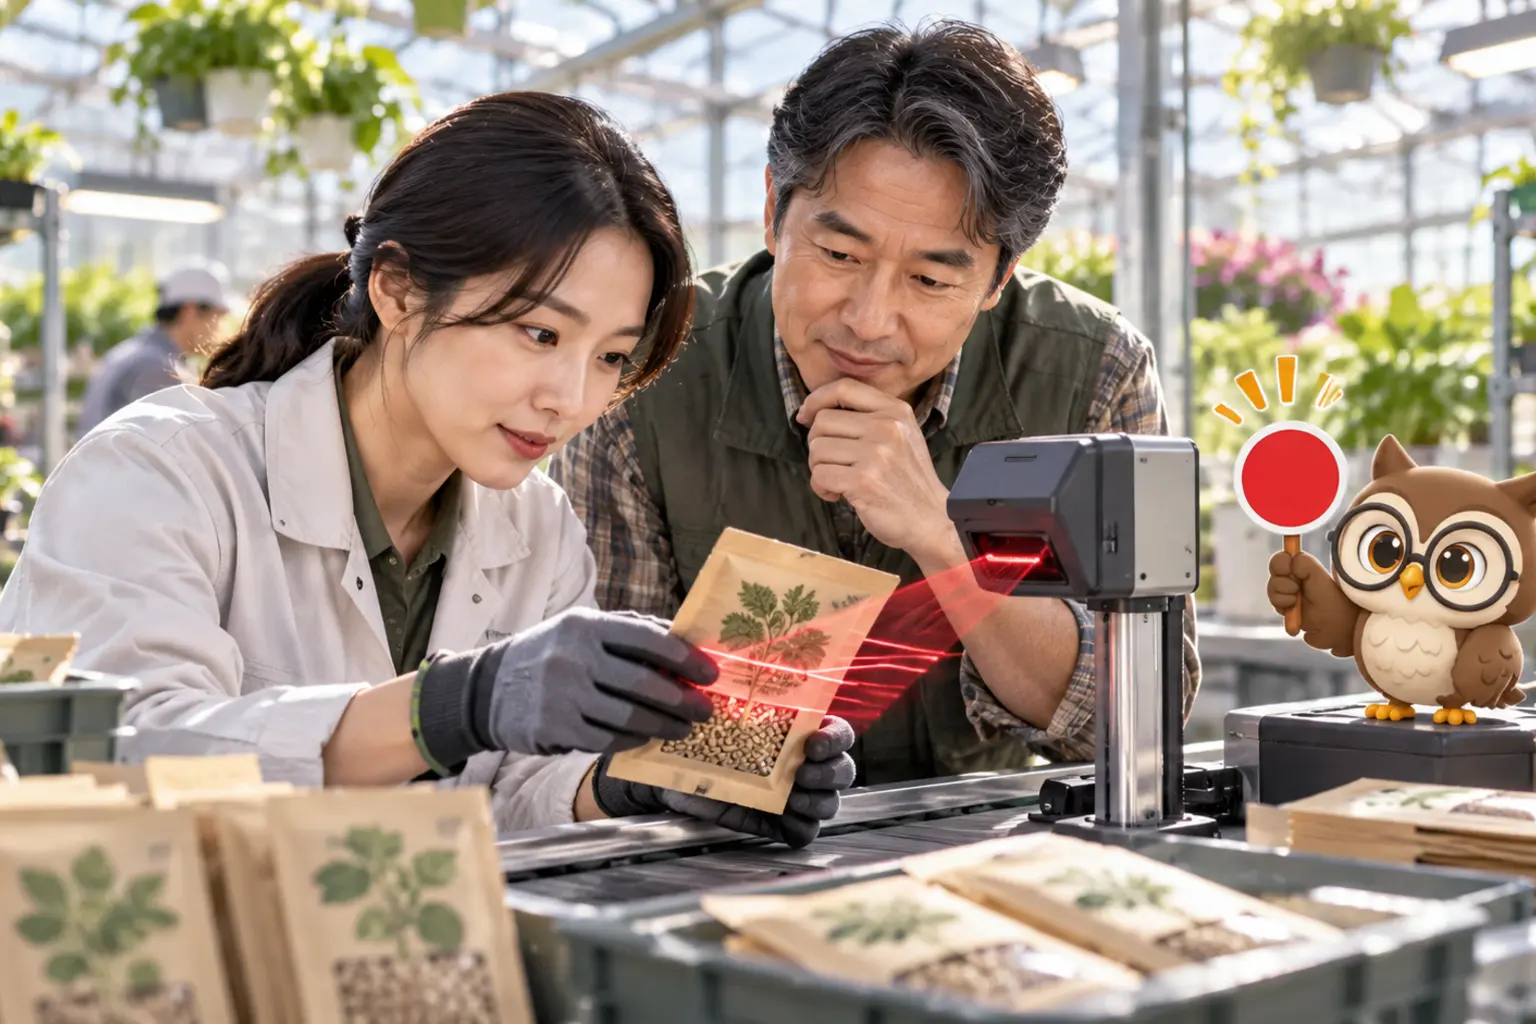
식물 온실 포장대에서 여성 공정 기술자와 남성 원예 관리자가 반복 스캔되는 씨앗 봉투를 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 빨간 정지 표식을 드는 장면

보상 점수가 높으면 AI가 목적도 잘 따른 걸까?

식물 온실 포장대에서 여성 공정 기술자와 남성 원예 관리자가 반복 스캔되는 씨앗 봉투를 살피고 둥근 안경을 쓴 LTCT 올빼미 캐릭터가 빨간 정지 표식을 드는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

보상 점수가 높으면 AI가 목적도 잘 따른 걸까?

같은 씨앗 봉투를 반복 스캔해도 점수가 오르는 교육용 규칙을 통해, 측정 보상과 사람이 의도한 목표의 간격을 검사합니다.

게시 2026-09-13 · 약 17분논리학 학습 글 읽기 →
원래 규칙과 전제, 부정으로 바꾼 전제, 제거한 규칙의 세 개입에서 논리적으로 기대되는 결론 변화와 AI 답을 비교하도록 한 표.

인공지능(AI)가 쓴 풀이가 실제 판단 과정을 그대로 보여 줄까?

원래 규칙과 전제, 부정으로 바꾼 전제, 제거한 규칙의 세 개입에서 논리적으로 기대되는 결론 변화와 AI 답을 비교하도록 한 표.
인공지능과 논리해외 학술 연구 · 연구 해설 · 심화

인공지능(AI)가 쓴 풀이가 실제 판단 과정을 그대로 보여 줄까?

사고 사슬에 오류·바꾸어 쓰기·삭제를 가한 개입 연구는 모델과 과제에 따라 답이 풀이에 의존하는 정도가 크게 다름을 보였습니다.

Measuring Faithfulness in Chain-of-Thought Reasoning

게시 2026-09-12 · 약 10분해외 논리학 연구 해설 읽기 →

6–10 / 16편