한곳에서 찾는 논리 자료

통합검색

연구와 학습, 시험과 도서를 한곳에서 찾습니다.

검색 결과마다 자료의 코너와 성격을 표시합니다. 제목을 먼저 살펴보고 그림 카드와 기존 본문으로 이어 가세요.

세 연구자가 논문과 도표를 함께 검토하고 작은 갈색 안경 올빼미가 곁에서 책을 읽는 모습

관심 주제로 찾아보기

조건 초기화

검색 결과141건

검색 결과 제목

  1. 91인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?
  2. 92쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?
  3. 93듣지 않은 단어를 들었다고 기억할 수 있을까?
  4. 94한 번에 여러 번 맞히는 것과 며칠 간격으로 다시 맞히는 것 중 무엇이 오래갈까?
  5. 95AI 심판은 자기 계열의 답을 더 좋아할까?
원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

원 목표에서 변형 문제 묶음, 강화학습, 트리 탐색, Lean 커널 검증으로 이어지는 순환도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

인공지능(AI)가 한 문제를 푸는 동안 그 문제 주변의 변형을 새로 학습하면 증명력이 올라갈까?

AlphaProof는 Lean 검증 환경, 대규모 자기학습과 문제별 시험시점 강화학습을 결합해 2024 IMO 비기하 5문제 중 3문제를 풀었지만 막대한 계산비용과 형식화 범위가 제한입니다.

Olympiad-level Formal Mathematical Reasoning with Reinforcement Learning

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
두 개의 쉬운 부등식 조각이 재작성과 합성 노드를 지나 Lean 목표로 가며 중간 합성 지점에 병목 표시가 있는 흐름도

쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?

두 개의 쉬운 부등식 조각이 재작성과 합성 노드를 지나 Lean 목표로 가며 중간 합성 지점에 병목 표시가 있는 흐름도
인공지능과 논리해외 학술 연구 · 연구 해설 · 일반

쉬운 부등식을 합성한 문제에서 증명 인공지능(AI)가 갑자기 약해질까?

Ineq-Comp v2를 바탕으로 익숙한 부등식의 변수 복제·대수 재작성·다단계 합성이 현재 Lean 증명 모델의 구성적 일반화를 크게 흔드는지 살펴봅니다.

Ineq-Comp: Benchmarking Human-Intuitive Compositional Reasoning in Automated Theorem Proving on Inequalities

게시 2026-09-13 · 약 10분해외 논리학 연구 해설 읽기 →
제시된 네 단어가 의미 중심 단어로 모이지만 실제 제시 기록에는 중심 단어가 빈칸으로 남아 있다.

듣지 않은 단어를 들었다고 기억할 수 있을까?

제시된 네 단어가 의미 중심 단어로 모이지만 실제 제시 기록에는 중심 단어가 빈칸으로 남아 있다.
인간의 사고와 추론해외 학술 연구 · 연구 해설 · 심화

듣지 않은 단어를 들었다고 기억할 수 있을까?

DRM 과제는 의미적으로 연결된 단어 목록이 제시되지 않은 중심 단어의 거짓 회상과 재인을 유발하는 방식을 보여 줍니다.

The Deese-Roediger-McDermott (DRM) Task: A Simple Cognitive Paradigm to Investigate False Memories in the Laboratory

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
초기 한 세션의 반복과 월 수 다음 월요일의 간격 재학습을 나란히 놓고 한 달 뒤 회상을 비교하는 시간선

한 번에 여러 번 맞히는 것과 며칠 간격으로 다시 맞히는 것 중 무엇이 오래갈까?

초기 한 세션의 반복과 월 수 다음 월요일의 간격 재학습을 나란히 놓고 한 달 뒤 회상을 비교하는 시간선
논리교육과 평가해외 학술 연구 · 연구 해설 · 일반

한 번에 여러 번 맞히는 것과 며칠 간격으로 다시 맞히는 것 중 무엇이 오래갈까?

세 실험 533명과 10만 건 넘는 단답 응답에서 초기 정답 반복의 이득은 재학습이 늘수록 줄었고, 넓은 간격의 재학습은 비교적 적은 추가 비용으로 장기 기억을 높였습니다.

Optimizing Schedules of Retrieval Practice for Durable and Efficient Learning: How Much Is Enough?

게시 2026-09-13 · 약 9분해외 논리학 연구 해설 읽기 →
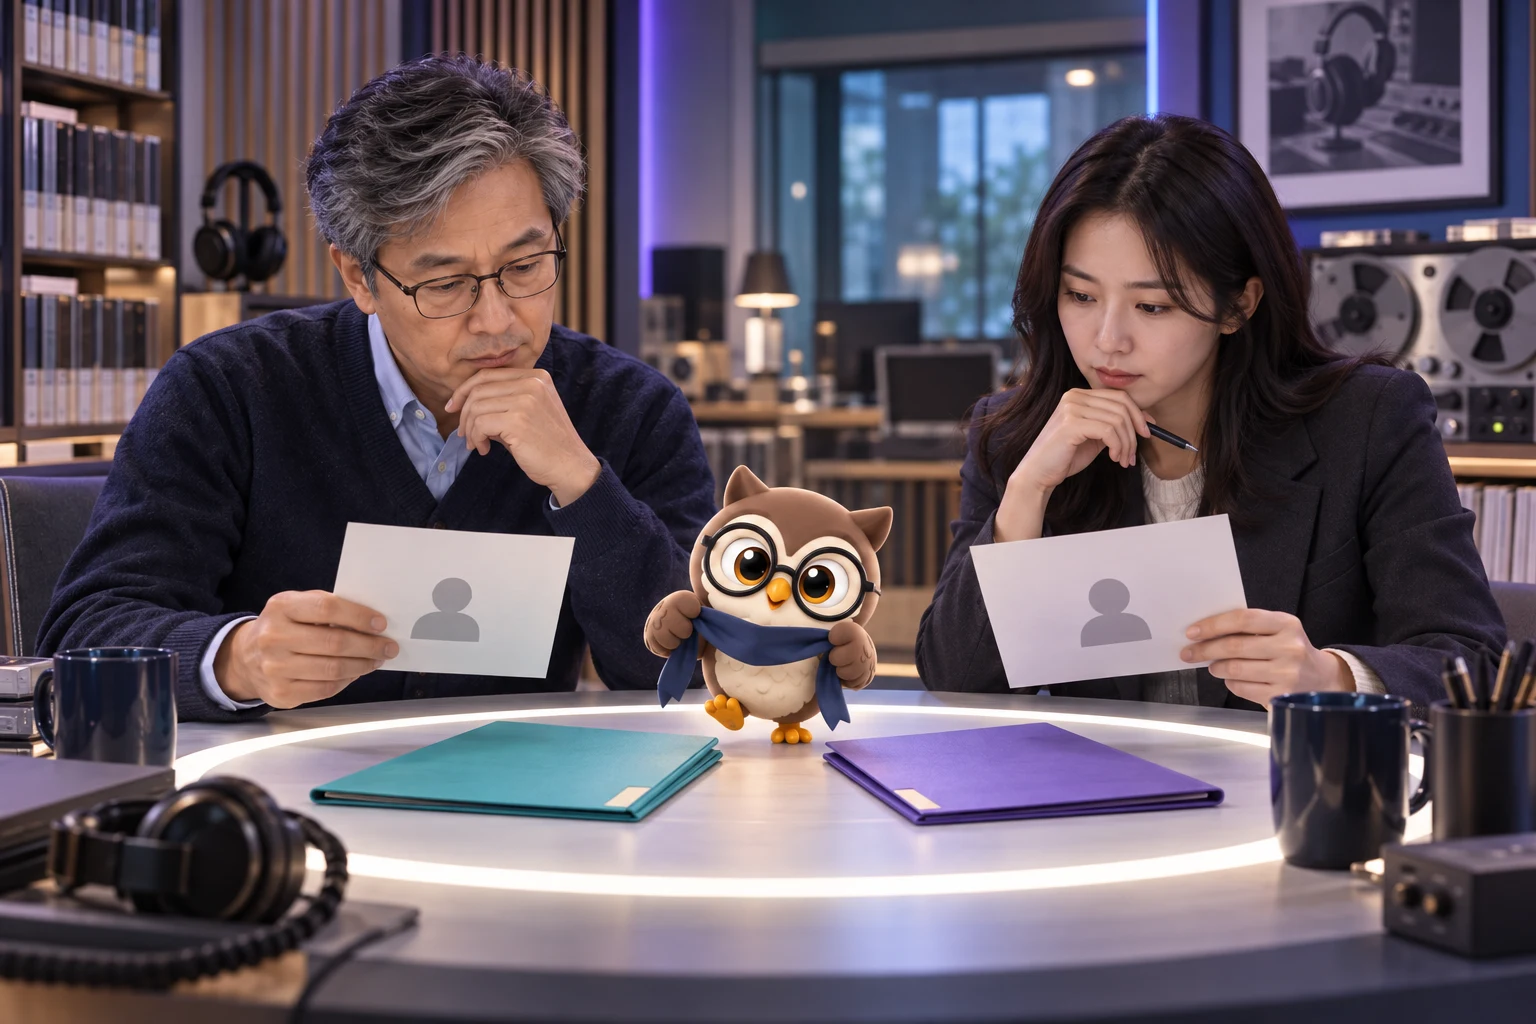
현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면

AI 심판은 자기 계열의 답을 더 좋아할까?

현대적인 라디오 기록 보관실에서 남성 음향 기록가와 여성 평가 책임자가 익명 답안 두 장을 비교하고 둥근 안경의 LTCT 올빼미 캐릭터가 청록·보라 파일 사이에서 눈가리개 끈을 들고 뛰는 장면
인공지능과 논리논리학 배우기 · 주제별 학습 · 심화

AI 심판은 자기 계열의 답을 더 좋아할까?

내용 조건은 같은 익명 답 A·B를 심판 A·B와 사람 루브릭이 평가할 때 88:78, 77:87, 80:80으로 달라지는 교육용 감사를 수행합니다.

게시 2026-09-13 · 약 18분논리학 학습 글 읽기 →

91–95 / 141편