
AI 보이는 추론 실험실 · 정책 변경 회귀검사

AI 안전 규칙을 바꾸면 한 오류는 줄고 다른 오류는 늘 수 있을까?

위험 요청을 놓치는 오류와 안전한 요청을 잘못 거절하는 오류를 함께 셉니다. 한 지표만 좋아졌을 때 전체 정책을 개선했다고 말할 수 있는지 살펴봅니다.

탐구게시 2026-09-27읽기·실험 약 11분확인 문제 2개교육용 계산한국논리학협회 자체 제작제작·검수 LTCT 편집부

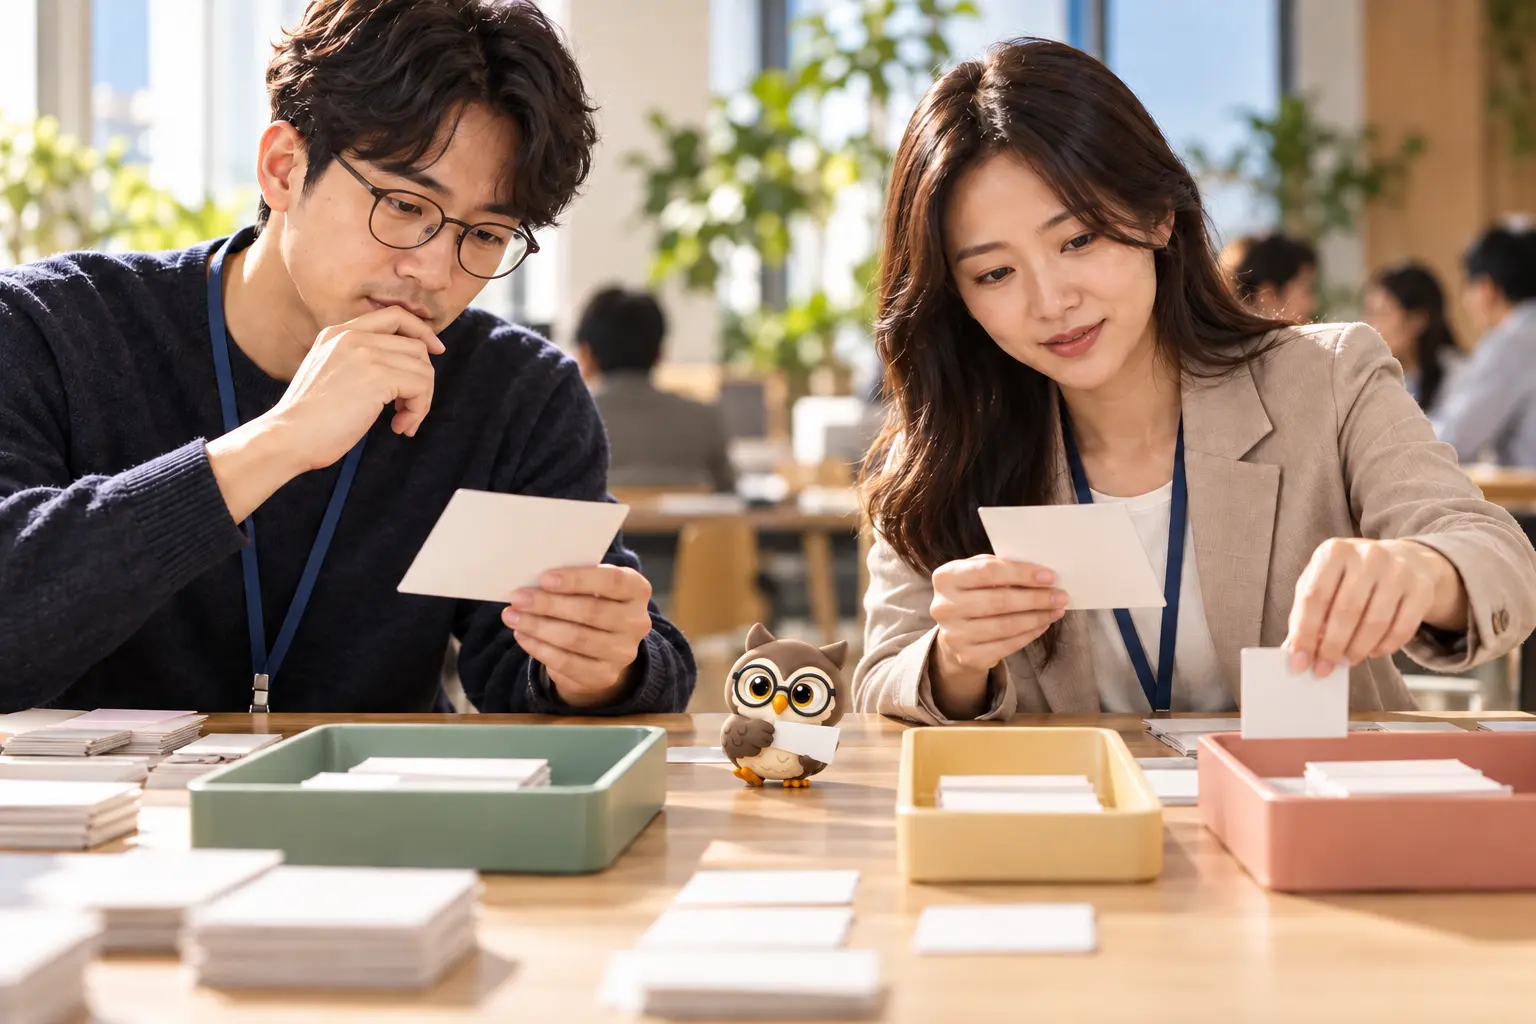
워크숍에서 교사와 개발자가 정책 변경 전후 오류 표를 비교하고 작은 갈색 안경 LTCT 올빼미가 곁에서 시험 카드를 기록하는 장면
주제 이해를 돕기 위한 AI 생성 이미지 · LTCT 자체 제작
오늘의 질문

새 규칙에서 위험한 요청을 더 많이 막았지만 안전한 요청도 더 많이 거절했다면, 정책이 좋아졌다고 한 숫자로 말할 수 있을까요?

정책 변경 전후에 위험 요청 차단과 안전 요청 허용을 같은 시험 묶음으로 비교하는 그림입니다.
정책 변경 전후에 위험 요청 차단과 안전 요청 허용을 같은 시험 묶음으로 비교하는 그림입니다. · 한국논리학협회 자체 제작
그림 크게 보기 ↗
01

정책 변경 전후를 같은 시험 묶음으로 비교합니다

AI 안전 규칙을 바꾸고 위험 요청의 차단률만 보면 개선처럼 보일 수 있습니다. 하지만 안전한 요청을 잘못 거절하는 횟수도 함께 바뀔 수 있습니다. 두 오류는 서로 다른 영향을 만듭니다.

이 글의 가상 기본값에서 변경 전 정책은 위험 10건 중 7건을 막고 안전 10건 중 8건을 허용합니다. 변경 후 정책은 위험 9건을 막지만 안전 요청은 6건만 허용합니다.

02

놓친 위험과 불필요한 거절을 따로 셉니다

변경 전에는 위험 놓침 3건, 불필요한 거절 2건입니다. 변경 후에는 위험 놓침 1건, 불필요한 거절 4건입니다. 전체 오류 수는 둘 다 5건이지만 오류의 종류가 달라졌습니다.

어떤 오류를 더 무겁게 볼지는 사용 맥락에 따라 달라집니다. 비용 가중치를 바꾸면 같은 결과표에서도 선호하는 정책이 달라질 수 있습니다. 가중치는 먼저 정하고 이유를 기록해야 합니다.

03

회귀검사는 좋아진 항목과 나빠진 항목을 함께 찾습니다

NIST AI RMF는 배포된 AI가 의도대로 작동하는지 지속적인 검사와 관찰로 확인하는 관점을 제시합니다. 정책 변경 뒤에는 새 위험 사례뿐 아니라 예전에 잘 처리한 사례도 다시 시험해야 합니다.

변경 전후의 자료 분포와 난도가 같아야 직접 비교하기 쉽습니다. 실제 운영에서는 집단별 영향, 심각도, 사람 검토, 새로 등장한 사례도 함께 확인해야 합니다. 이 계산의 20건만으로 실제 정책 안전성을 판단할 수는 없습니다.

참고 · NIST AI Risk Management Framework 1.0 — 배포된 AI의 지속적인 검사와 관찰 ↗

직접 확인하기 · 교육용 계산

위험 놓침과 불필요한 거절의 비용을 함께 비교하기

위험 요청 10건과 안전 요청 10건을 검사하는 가상 모형입니다. 민감도는 위험 요청을 차단하는 비율, 특이도는 안전 요청을 허용하는 비율입니다. 비용 비중은 의사결정 기준을 탐구하기 위한 값이며 실제 안전 기준이 아닙니다.

변경 전 오류위험 놓침 3 · 불필요한 거절 2
변경 후 오류위험 놓침 1 · 불필요한 거절 4
변경 전 가중 비용11
변경 후 가중 비용7
정한 비용 비중에서는 변경 후 정책이 낮습니다.

가중 비용은 실제 안전성 점수가 아니라 선택한 우선순위를 드러내는 계산입니다. 사례 심각도와 집단별 영향을 추가로 확인해야 합니다.

관계를 읽고, 다른 상황에 적용하기

두 문제로 생각 확인

1변경 후 정책이 위험 놓침을 3건에서 1건으로 줄였지만 불필요한 거절을 2건에서 4건으로 늘렸습니다. 가장 알맞은 해석은 무엇인가요?
2정책 변경 회귀검사에 포함해야 할 자료는 무엇인가요?

두 문제의 답을 모두 선택하면 해설을 볼 수 있습니다.

나의 설명으로 마무리

오늘 발견한 관계

0 / 4,000자

메모는 현재 기기의 브라우저에만 보관됩니다. 계정이나 다른 기기에는 동기화되지 않습니다.

출처와 제작 안내

원문을 참고해 설명·도표·문항·실험을 새로 작성했습니다. 별도 표시가 없는 사례와 수치는 학습을 위한 가상 예시입니다. 원문 번역이나 실제 모델의 성능 평가 자료가 아닙니다.

  1. 배포된 AI의 지속적인 검사와 관찰 ↗NIST AI Risk Management Framework 1.0AI Risks and Trustworthiness — Valid and Reliable

    배포된 AI가 의도대로 작동하는지 지속적인 검사나 관찰로 신뢰성과 타당성을 확인한다는 설명을 참고했습니다. 정책 전후 20건의 결과와 비용 가중치는 자체 가상 자료입니다.