
정답과 정답을 만든 단서는 별개의 검사 대상이다
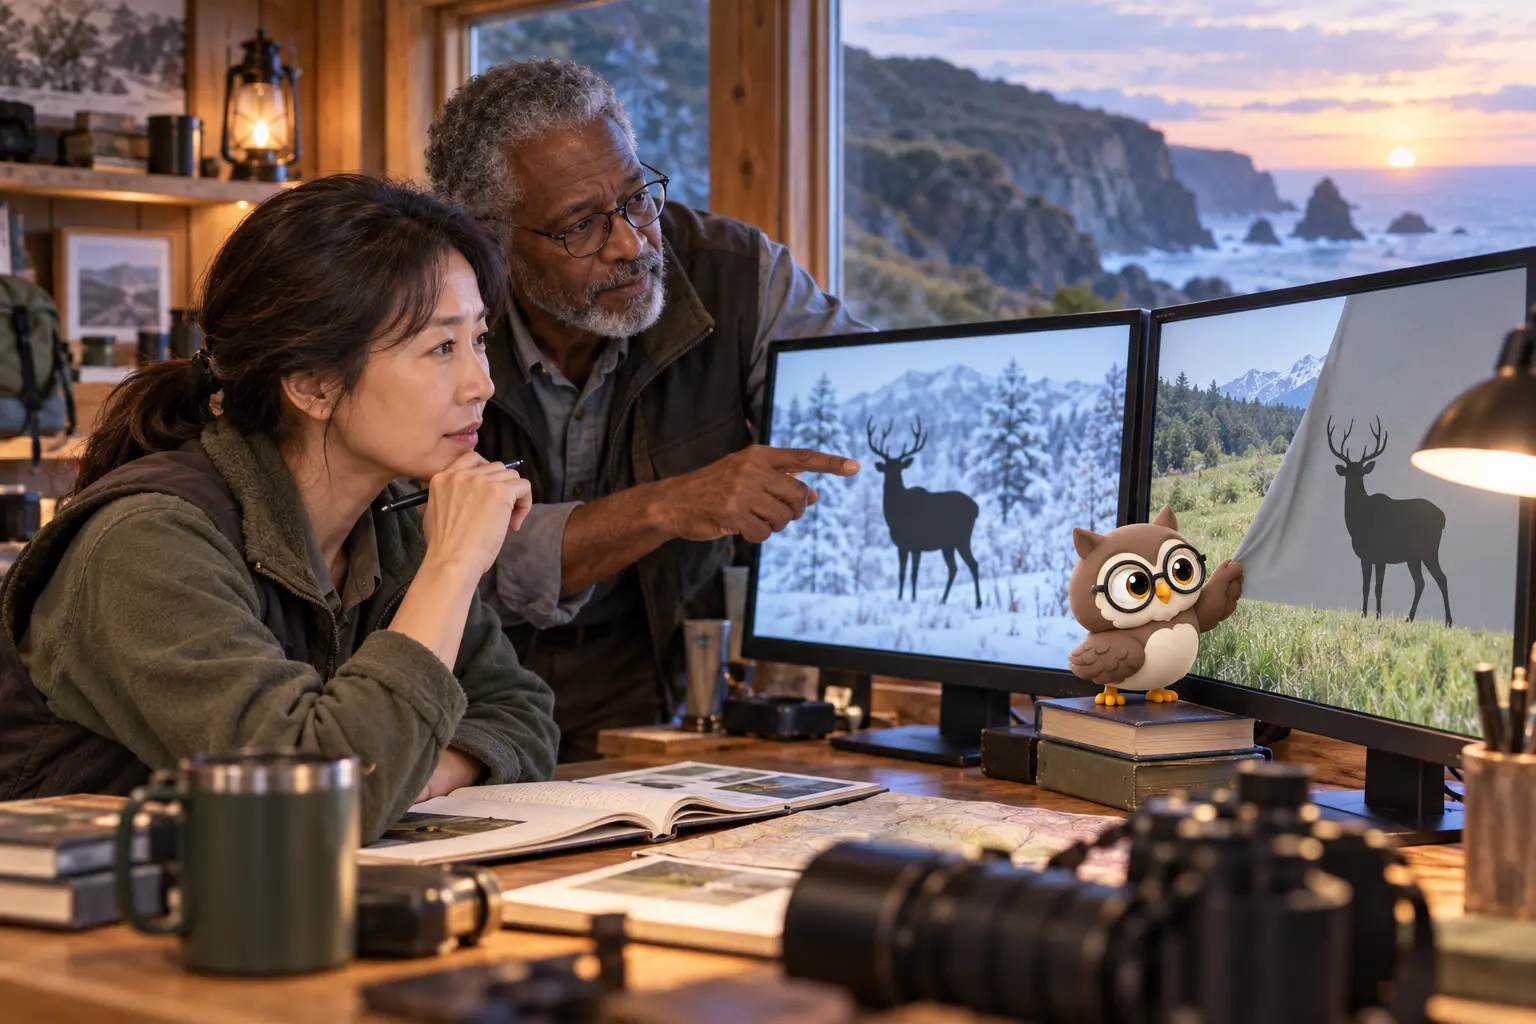
사슴 사진 분류기가 검증 자료의 대부분을 맞혔다고 합시다. 우리는 뿔과 몸의 윤곽을 배웠다고 기대하지만, 훈련 사진의 사슴 뒤에 늘 눈이 있고 다른 동물 뒤에는 풀이 있었다면 눈 배경도 손쉬운 정답 단서가 됩니다. 새 장소에서 배경과 동물의 짝이 달라지면 같은 계산 규칙이 갑자기 실패할 수 있습니다.
Ribeiro, Singh, Guestrin은 2016년 논문에서 이런 상황을 의도적으로 만들었습니다. 늑대와 허스키를 합한 훈련 사진 20장을 손으로 골라, 늑대 사진은 모두 눈 배경이고 허스키 사진에는 눈 배경이 없도록 구성했습니다. 추가 60장에서 분류기는 동물의 색·자세보다 눈이나 화면 아래의 밝은 배경에 따라 늑대를 예측했습니다. 이는 연구진이 실제 운영 모형의 성과로 제시한 결과가 아니라 설명 방법을 시험하기 위한 나쁜 분류기 사례입니다.
연구의 10개 예측 중 8개가 맞았어도 두 예외는 배경 짝이 바뀐 사진이었습니다. 27명의 대학원생에게 설명을 보여 주기 전 눈 단서를 언급한 사람은 12명, 뒤에는 25명이었고 나쁜 분류기를 신뢰한 사람은 10명에서 3명으로 줄었습니다. 연구진도 표본이 작다는 조건을 함께 적었습니다.
참고 · Marco Tulio Ribeiro·Sameer Singh·Carlos Guestrin / KDD 2016 — 눈 속 배경을 늑대 단서로 쓴 분류기 ↗
단서를 하나씩 가리고 반대 자리에 붙여 본다
지름길을 확인하려면 대상은 유지하고 의심 단서만 바꿉니다. 같은 사슴 윤곽을 눈밭과 풀밭에 놓고, 모서리 표식을 가리거나 다른 사진에 붙여 예측이 변하는지 비교합니다. 예측이 배경 교체에 크게 흔들리고 대상 특징 제거에는 둔감하다면, 분류 기준이 우리가 의도한 대상과 어긋났다는 구체적 증거가 됩니다.
Lapuschkin 등은 2019년 연구에서 PASCAL VOC 말 분류기의 관련도 지도가 이미지 아래 출처 표식에 모이는 경우를 찾았습니다. 표식을 자르면 말 판정이 약해지고 자동차 사진에 붙이면 말 쪽으로 바뀌었습니다. 또 항공기 분류에서 정사각형 입력을 만들기 위한 인공 패딩이 단서가 된 전략도 보고했습니다. 자료 수집과 전처리의 흔적까지 점검해야 하는 이유입니다.
관련도 지도나 국소 설명은 특정 입력의 픽셀·구역 기여를 요약하는 분석 결과입니다. 모델이 사람처럼 마음속 문장으로 생각했다는 기록도, 전체 계산의 완전한 복사본도 아닙니다. 설명에서 의심 구역을 찾고 실제 입력을 수정해 예측 변화를 재검사할 때 근거가 한 단계 강해집니다.
운영 환경에서 바뀔 단서를 먼저 목록으로 만든다
아래 활동의 대상 중심 모형은 동물 특징 8점·눈 배경 1점·표식 0점, 지름길 모형은 각각 2점·5점·7점을 더하고 6점 이상이면 사슴으로 판정합니다. 모두 자체 제작한 계산입니다. 같은 동물을 둔 채 눈 배경을 끄거나 표식만 켜 보세요. 두 모형이 같은 정답을 낼 때에도 점수 구성은 다르게 나타납니다.
실제 검수에서는 배경·촬영 장비·기관 표식·압축 흔적·문서 양식처럼 배포 뒤 달라질 수 있는 단서를 적습니다. 대상은 고정하고 의심 단서를 바꾼 짝 자료, 대상 단서를 지우고 배경만 남긴 자료, 새로운 장소에서 모은 자료를 나누어 시험합니다. 전체 정확도와 함께 단서 변화별 예측 안정성을 보고해야 합니다.
다른 상황으로 옮기면 엑스레이 기기 표시, 학교별 문서 서식, 상품 사진의 스튜디오 배경도 후보가 됩니다. ‘AI가 무엇을 보았는가?’를 한 장의 설명으로 끝내지 말고, 어느 입력에서 나온 설명인지와 어떤 수정 실험으로 확인했는지를 연결해 기록하세요. 그러면 보이는 설명이 검증 가능한 가설로 바뀝니다.