
인공지능(AI)가 주장 문장을 찾으면 논증 구조도 모두 찾은 걸까?
논증 마이닝은 주장·전제의 식별뿐 아니라 관계, 생략, 맥락과 장르까지 다뤄야 하며 과제마다 주석 단위와 평가 기준이 다릅니다.
그림에서 무엇을 볼까요?
문장 경계 탐지에서 구성요소 분류, 지지·공격 관계, 문맥 검토로 이어지는 네 단계 논증 마이닝 도식
‘도서관 운영시간을 늘리자. 야간 이용 설문에서 68%가 찬성했다. 다만 표본은 야간 이용자였다.’에서 첫 문장은 주장, 둘째는 지지 근거, 셋째는 근거 범위를 제한하는 반론입니다.
구성요소만 맞히면 세 문장에 색을 칠하는 데 그칩니다. 관계까지 읽으면 2→1 지지와 3→2 제한을 구분해야 합니다. ‘68%’를 전체 학생 비율로 바꾸어 쓰면 구조를 찾았어도 내용 충실성이 깨집니다.
함께 확인할 점
조사 논문은 여러 데이터셋과 방법을 종합하며 하나의 통합 성능 수치를 제시하는 실험이 아닙니다.
영어 중심 자료의 단위와 담화 표지를 한국어에 그대로 적용하면 조사·생략·어순의 차이를 놓칠 수 있습니다.
생각해 볼 질문
주장과 전제를 모두 정확히 찾았는데도 논증지도가 틀릴 수 있는 이유는 무엇인가요?
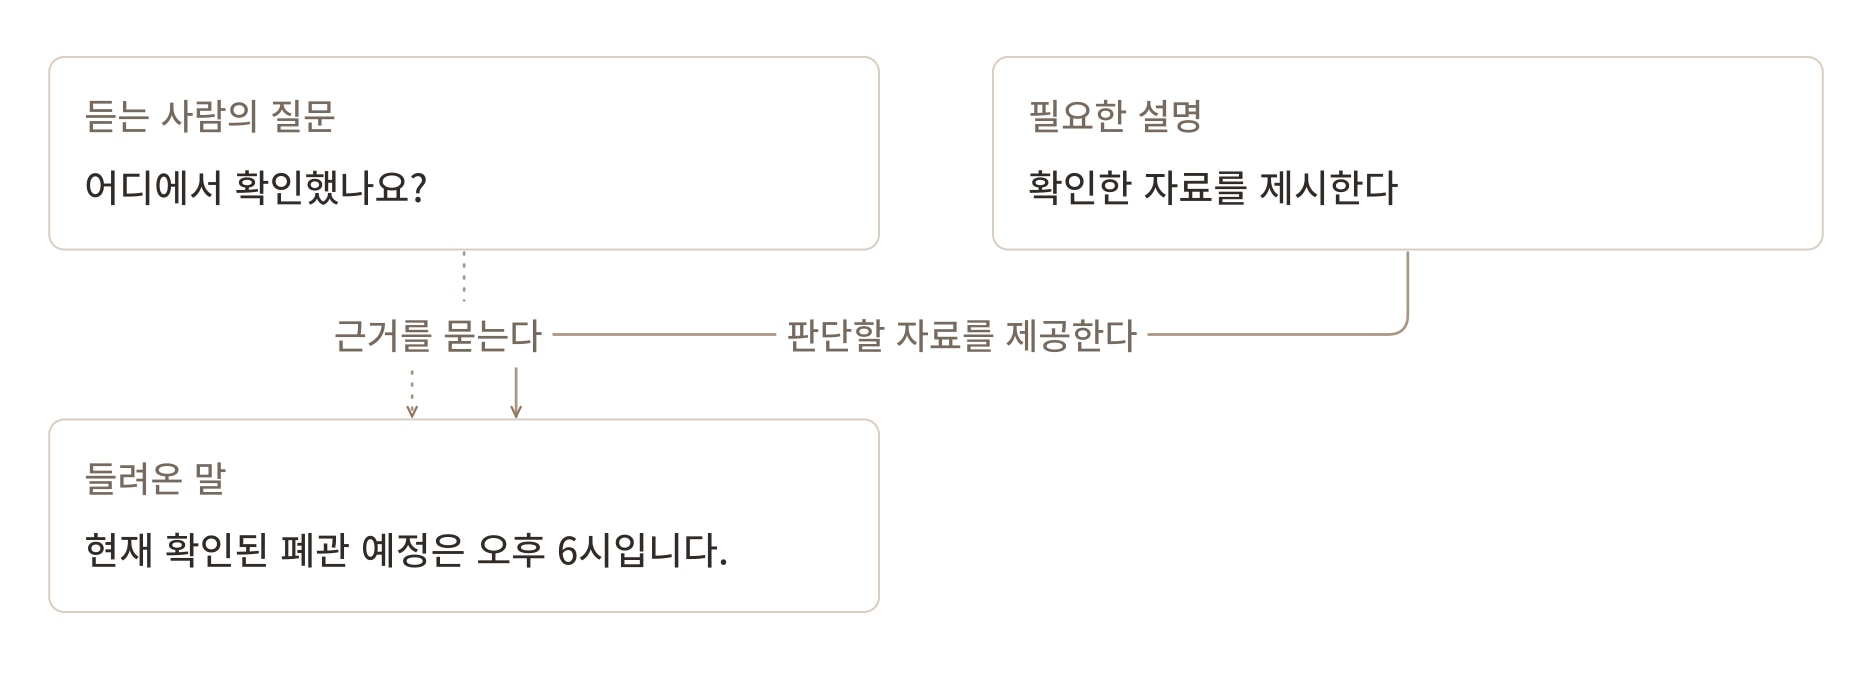 말과 확인할 근거를 연결하는 생각그림
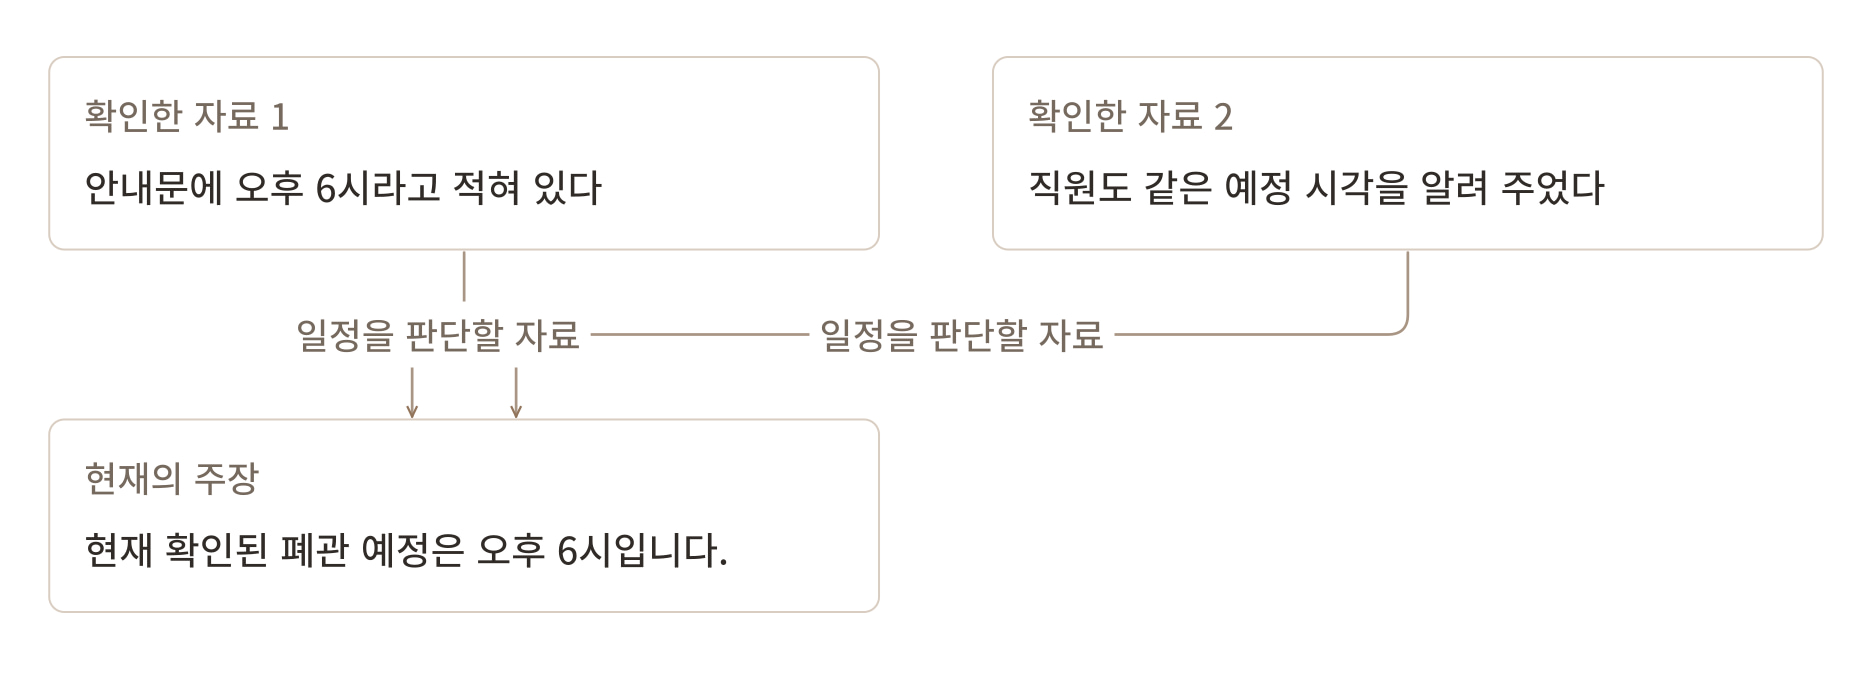 말과 이유를 나누어 놓는 생각그림
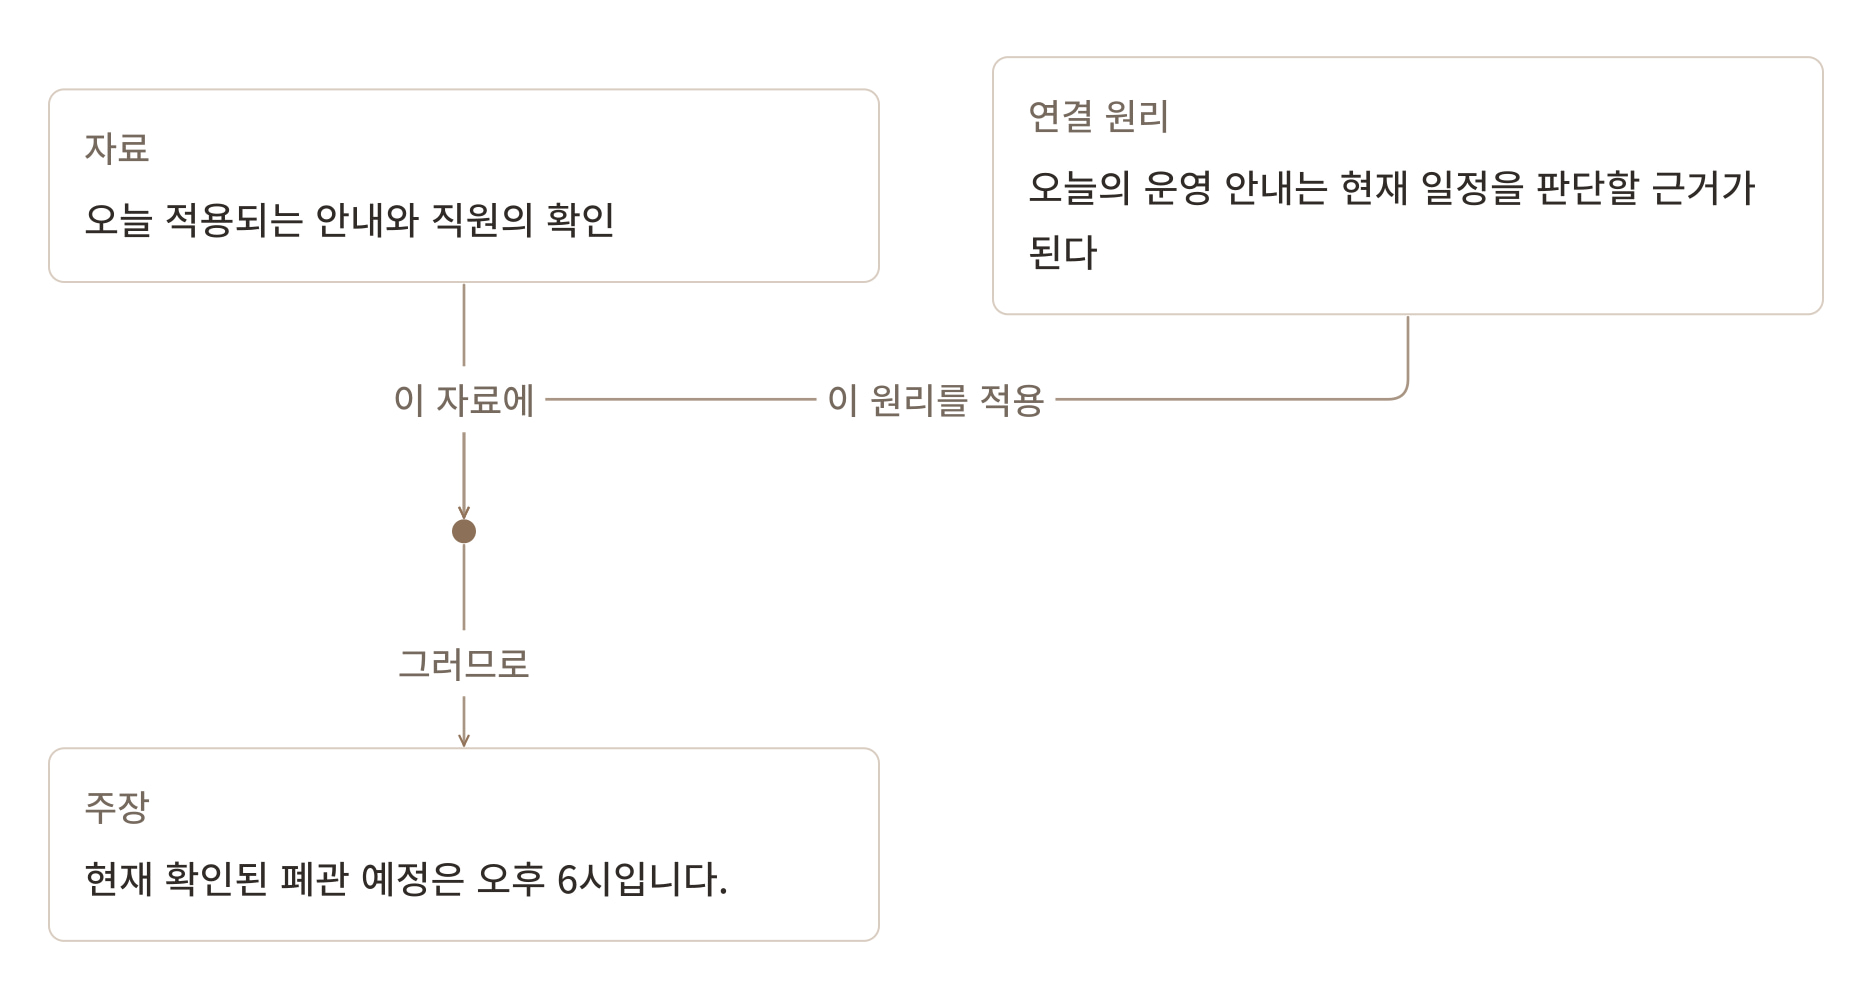 화살표의 연결 이유를 설명하는 생각그림