
인공지능(AI)가 식을 프로그램으로 쓰면 계산 실수는 줄어들까?
Program of Thoughts는 언어모델이 계산까지 문장으로 이어 쓰는 대신, 추론을 실행 가능한 프로그램으로 표현하고 계산은 외부 실행기에 맡깁니다.
그림에서 무엇을 볼까요?
문장제에서 변수와 식을 추출해 제한된 프로그램을 실행하고 의미 검산으로 돌아가는 네 단계 흐름도.
가상 문제는 ‘한 권 12,000원인 책 3권을 사고 전체 금액의 10%를 할인한 뒤 배송비 2,500원을 더한다’입니다. 아래 활동에서 수량·할인율·배송비를 바꾸면 프로그램 모형이 중간값과 최종값을 다시 계산합니다. 실행되는 것은 페이지 안의 단순 산술 함수이며 실제 언어모델이나 외부 API가 아닙니다.
자연어를 ‘subtotal = price × quantity’, ‘discounted = subtotal × (1-rate)’, ‘total = discounted + shipping’으로 나누면 계산 경로를 확인할 수 있습니다. 그러나 배송비가 할인 전 기준인지, 할인 대상인지 문제 해석을 잘못하면 코드는 일관되게 잘못된 답을 냅니다.
함께 확인할 점
확인한 버전은 arXiv v4와 TMLR 2023 게재본이며 주로 Codex와 여덟 수치 데이터셋을 사용했습니다. 현재 모든 모델·언어·과제로 일반화할 수 없습니다.
코드 실행은 산술 오류를 줄일 수 있지만 문제 번역, 단위, 데이터 선택, 보안 오류를 자동으로 해결하지 않습니다.
생각해 볼 질문
프로그램이 오류 없이 실행되면 추론도 옳은가요?
 풀이 예시를 보여 주면 작은 인공지능(AI)도 추론을 잘하게 될까?
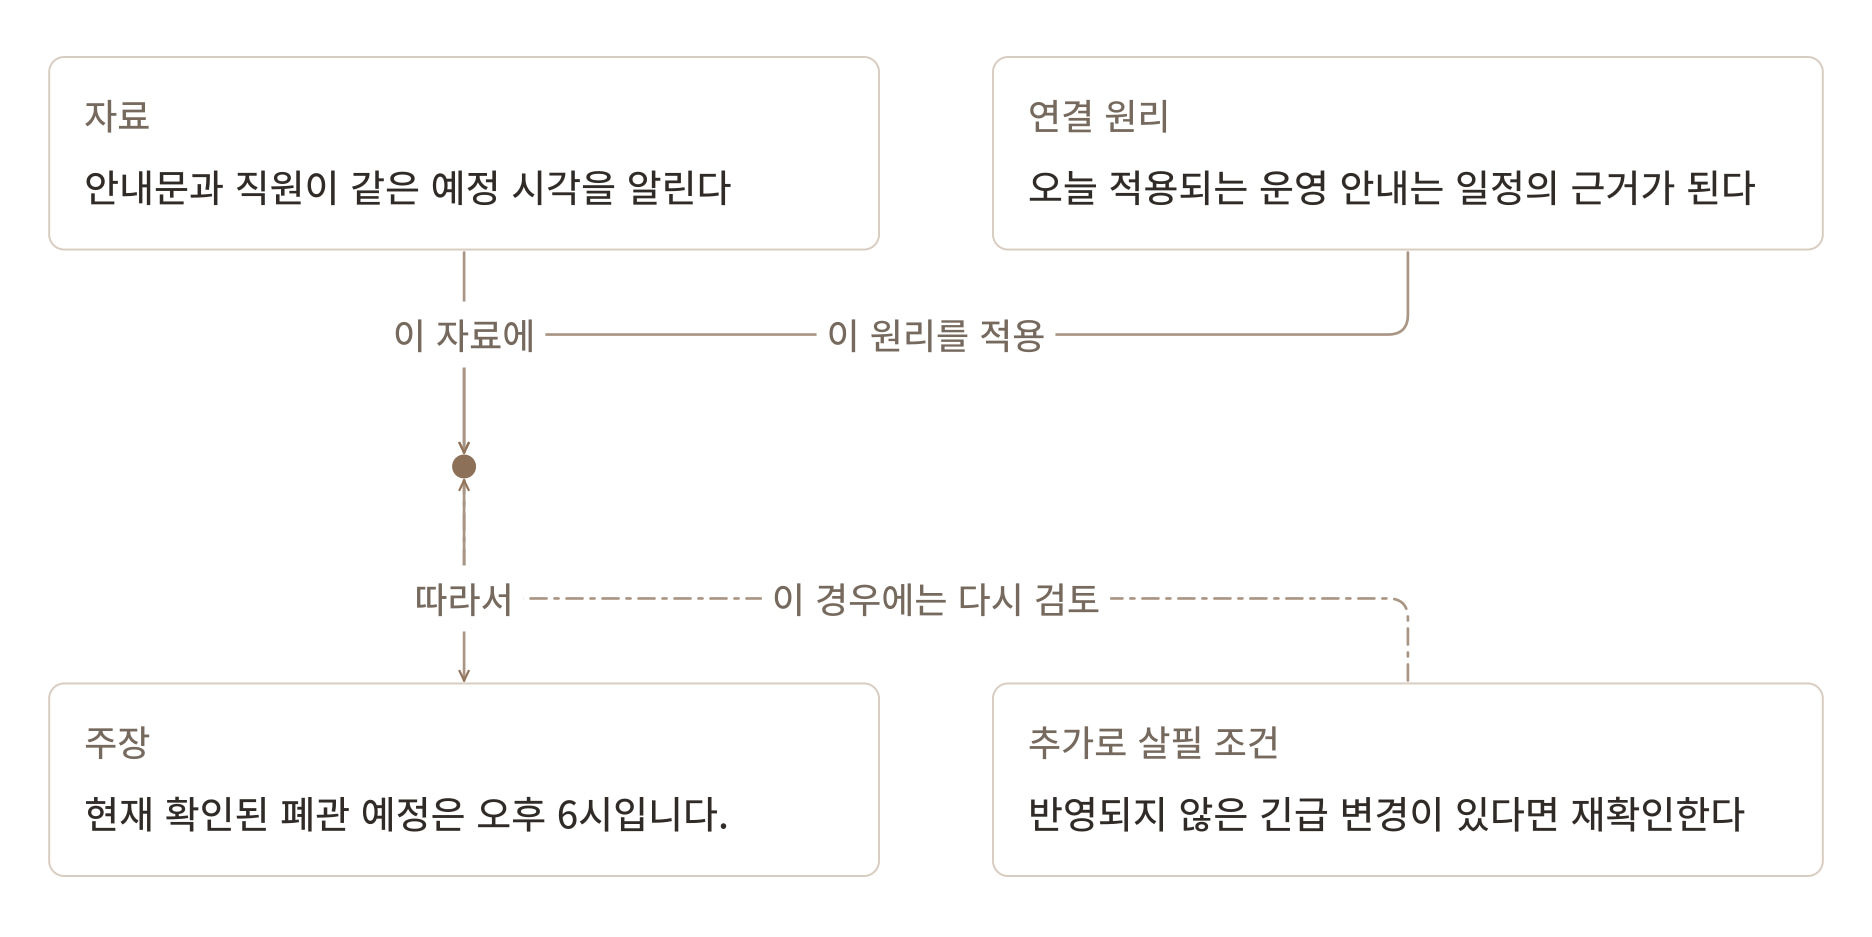 생각그림을 한 문단으로 펼치기
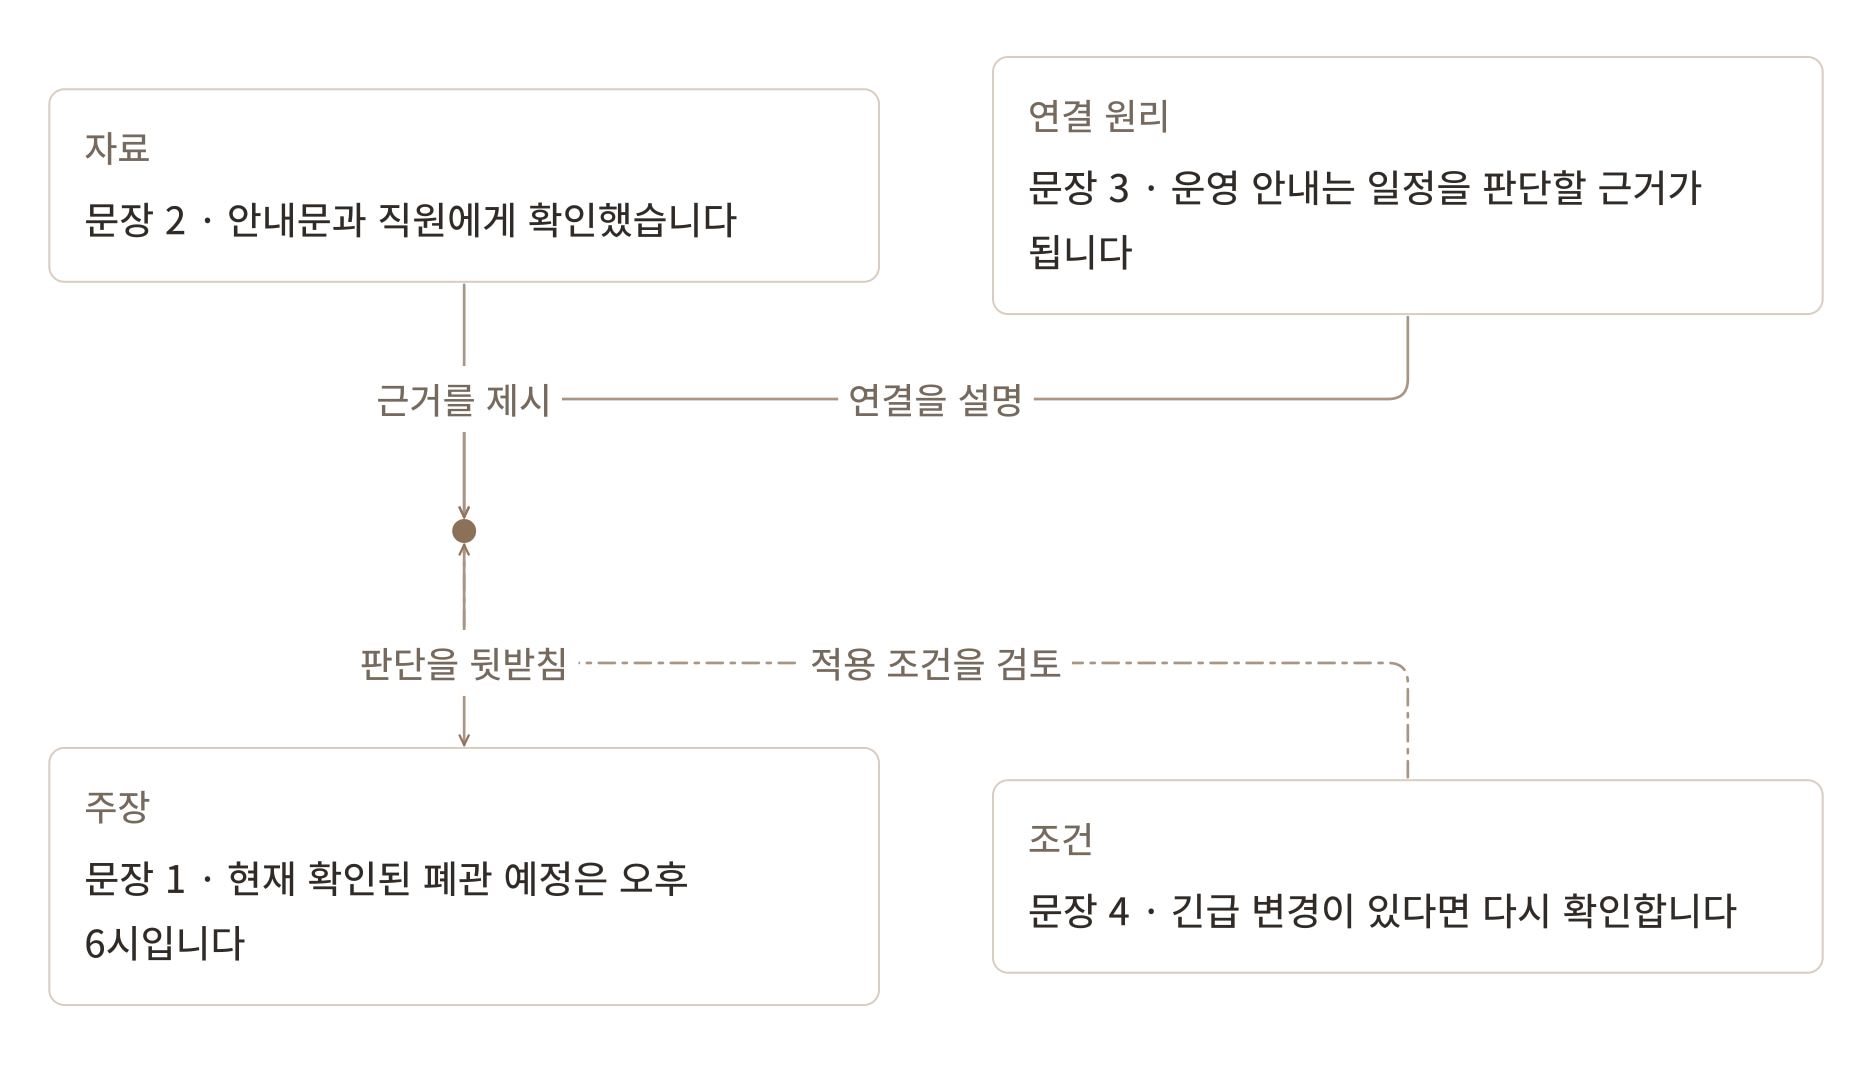 쓴 문단을 다시 생각그림으로 읽기